

 有用科技小编2026/10/22
 浏览9756
 阅读6分钟
文字版 PDF 里的整份文字可以一次拿出来:用「软领PDF阅读转换器」的「转换」→「PDF转TXT」打开文件、点「开始转换」、再打开生成的 TXT,实测 3 页房屋租赁合同导出约 3000 字,整份内容一次到手。手边只想拿当前这一页的文字,走「开始/转换」→「提取文字」更省事。
用「软领PDF阅读转换器」把整份文字一次导出
文字版 PDF 里每一页的字都能选中,这个功能把它们一次性导出成 TXT 文本,不用一页一页复制粘贴。
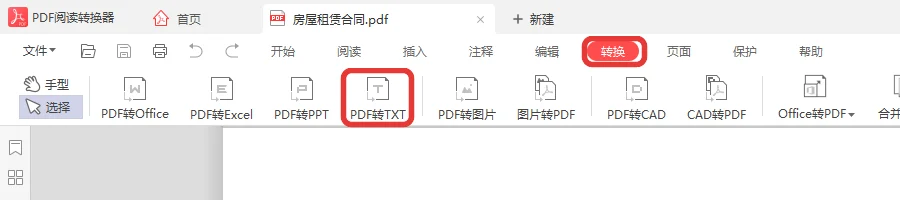
第1步 打开「转换」里的「PDF转TXT」
点软件顶部的「转换」,找到里面的「PDF转TXT」并打开。
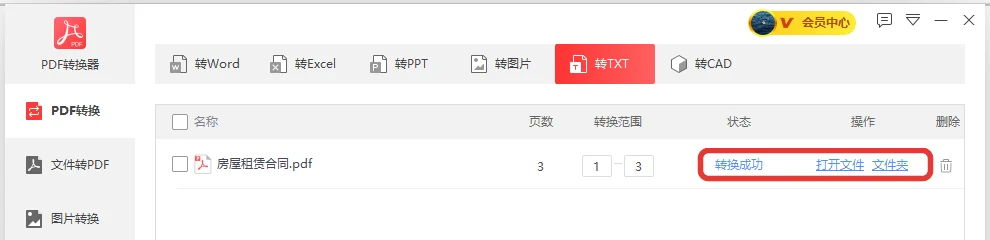
把要提取文字的 PDF 添加进来,文件就出现在转换列表里。
第2步 确认页面范围,点「开始转换」
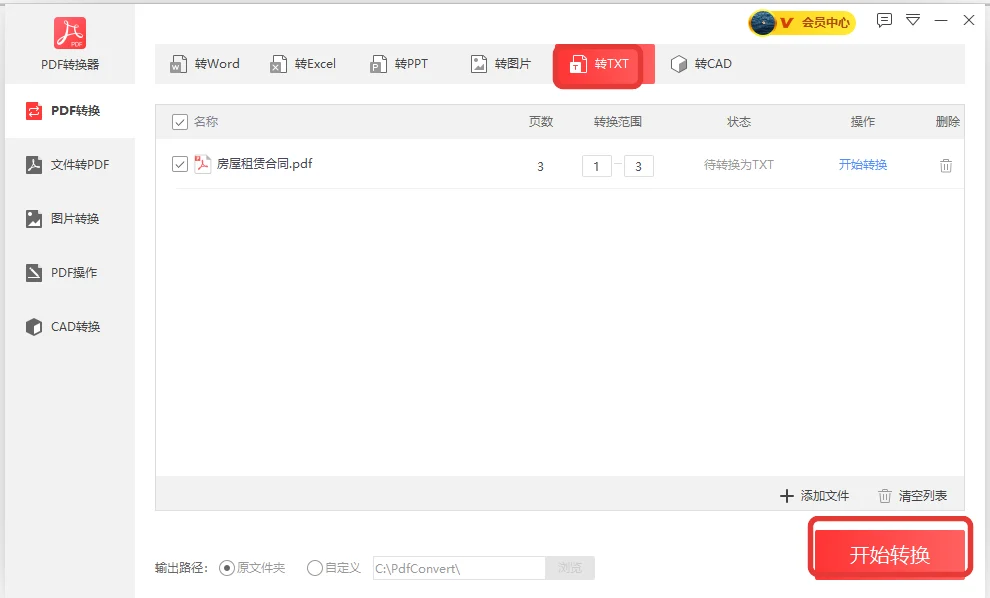
「PDF转TXT」的页面会把这份文件的每一页列出来,默认全部勾选。
确认范围没问题,点「开始转换」,软件就按勾选的页把文字导出来。
第3步 打开生成的 TXT 看整份文字
转换结束后,打开生成的 TXT 文本,整份文字都在里面,接着往下用就行。
不同文件该走哪个入口
文件是文字版还是扫描件,决定了该用哪个入口,选错的代价就是白转一趟。
| 文件情况 | 入口 | 结果 |
|---|---|---|
| 文字版 PDF,要整份文字 | 「转换」→「PDF转TXT」 | 整份文字导出成 TXT 文本 |
| 只要当前这一页的文字 | 「开始」→「提取文字」 | 识别结果直接取用,不用整份转换 |
| 扫描件,要可编辑的整份文字 | 「转换」→「扫描件转换」,转 Word 时勾上「精准转换模式」(「开始」里的「扫描件识别」是同一个入口) | 得到的是可编辑文字 |
| 扫描件,想一页一页核对 | 「图片OCR」 | 打开「提取文字」窗口,逐页识别 |
提取文字时容易卡住的几件事
扫描件直接转 TXT 会得到空文件
扫描件和图片型 PDF 里没有可以选中的文字层,用「PDF转TXT」导出的就是一个空文件。这类文件用「软领PDF阅读转换器」打开时,顶部会提示「检测到你的文档为扫描件,您可以针对文档进行如下操作」,后面跟着「图片OCR」「扫描件去背景」「此文档不提示」「所有文档不提示」。先识别出文字,才有内容可导。
「提取文字」窗口每次只认当前这一页
这个窗口左边是预览,下面有「重新选择」和「删除」,右边是「提取结果」。识别的范围只有当前这一页,要提取别的页,先用底部的页码框跳到那一页再点「开始提取」。
手头只有一张图也没关系,「重新选择」可以换成一张 png 或 jpg 图片来识别。
导出格式和保存位置可以自己定
窗口里的导出格式是 TXT 文本,保存路径能点「更改路径」换一个位置。识别完成后,原来的按钮会变成「复制全部」和「导出」,想直接复制还是存成文件都行。
为什么用「软领PDF阅读转换器」
装的时候放心。软领是知名国产软件品牌,20年技术沉淀,服务千万用户,安装包从官网 wyouhua.com 直接下载,无毒绿色、不带捆绑、插件和全家桶。
用的时候不被打扰。软领不靠广告挣钱,软件里不会冒出弹窗和广告,手上的活不会被打断。
用久了会发现它越用越好用,软件持续维护更新,功能一直跟着系统变化走。
真遇到问题也不慌。如今到处都是 AI 客服,想找到一个真人很难;软领旗下所有产品的界面上都有客服按钮,点一下就能联系到真人客服帮你解决电脑问题,复杂情况还有专业工程师远程协助。
大家常问
PDF 文字提取都需要先做 OCR 吗?
不一定。文字版 PDF 直接导出就能拿到整份文字,扫描件和图片型 PDF 才要多一道识别的工序。
PDF 文字提取出来,缩进和页脚还在吗?
还在。实测导出的 TXT 保留了原来的缩进,页脚「第 3 页 共 3 页」也照原样留着。
扫描件转出来的 Word 能直接改字吗?
能。实测 3 页合同扫描件勾上「精准转换模式」转出的 Word 有 979 字可编辑文字,里面没有嵌整页图片。
「图片OCR」要怎么才能用?
OCR 文字识别属于会员功能,开通会员后可用,对应「OCR文字识别」和「无限次OCR扫描」两项权益。
 pdf提取文字pdf文字提取pdf转txt软领PDF阅读转换器

 提示