


 有用科技小编2026/09/21
 浏览9813
 阅读10分钟
转完 Word 页码变成 1、1、2 或者每页都是同一个数字,先别急着改页脚:用阅读功能打开原 PDF 翻到页脚,看页码本来是页面里的文字,还是转换时补上去的。原文件没页码,就把转换补出来的页脚文本框删干净;长文档按页拆开分批转换,再用 Ctrl+H 把 ^m 分页符清空,最后在 Word 里重新插入页码、逐页比对。
这类问题多半来自转换时插进去的分页符和重复的页脚文本框,源文件本身一般没坏,重新导一次通常就能恢复。以下方法在 Windows 10/11 实测可用。
适用系统:Windows 10/11;最后更新:2026-09-21。
转完 Word 页码变成 1、1、2,问题出在哪一步
Word 页脚显示 1、1、2,或者翻到第 8 页还是「第 1 页 共 1 页」,多数是转换时把每页当成独立一页处理,页脚文本框和分页符一起被搬了过来。在 Word 里按 Ctrl+Shift+8 打开编辑标记,能看到每页底部挤着一排分页符和残留的文本框,正文被顶得七零八落。

先分清页码是原文件带的还是转换补出来的,再决定删还是修,能省去大量盲目重排的时间。
方法1 先确认原 PDF 的页码从哪来
页码是原文件自带的文字,还是转换时补出来的,决定了后面是删还是修。判断方法很直接:用阅读功能打开源 PDF,把光标点到页脚的数字上,看它能不能被选中。
操作步骤
- 用 PDF 阅读功能打开源 PDF,翻到页脚,光标点上去看能不能选中页码文字
- 能选中,说明页码属于页面文字层,转换会照搬;选不中而 Word 里却有,就是转换时补出来的
- 原文件本来没页码:Word 页脚里那个文本框框选后按 Delete 删掉,多余页码就没了
- 原文件有页码:重点查转换带进来的分页符和分节符,别去动页脚本身

能选中说明页码在页面文字层里,错位大概率出在分页符上;选不中而 Word 里却有数字,就是转换过程补的,删掉页脚文本框即可。先分清这一步,后面不用来回试。
方法2 长文档拆页后再转换
一次转几百页最容易页码错位,按页码范围拆成小文件分别转,能明显降低出错概率。拆开之后就算某一段乱了,也只需重转那一份,不用整本返工。
操作步骤
- 用 PDF 合并拆分,按页码范围把源文件拆成每份 30 到 50 页的小文件
- 逐个转成 Word,文件名带上页码范围,比如 001-050、051-100
- 转换时不要勾选自动识别页码、自动分节这类附加选项,减少事后返工
- 全部转完按编号顺序拼回一个文档,再统一看页脚数字是否连续
页数少的时候,转换程序要处理的页脚位置和分页判断也少,出错点自然就少,这是长文档最省力的一种转法。
用「软领PDF阅读转换器」更省事
与其转完 Word 再逐页找毛病,不如转换前就用「软领PDF阅读转换器」的 PDF阅读 功能打开源文件,翻到页脚位置点一下,看页码能不能被选中,提前判断它是原文文字还是转换补出来的。省掉的是「转完发现对不上、再回头拆页重转」的那一轮。
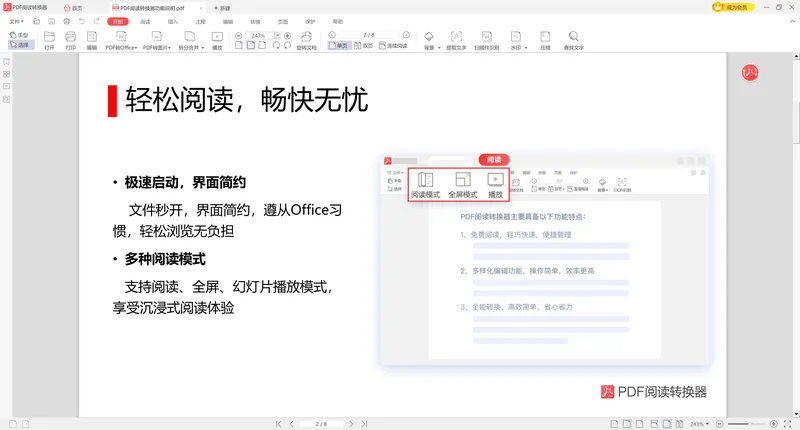
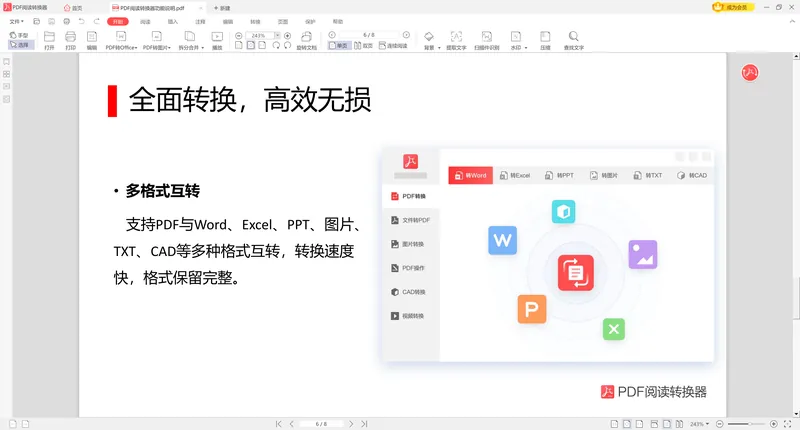
判断清楚之后,用它的 PDF转Word 功能转换,转换过程尽量保留原来的版面和页脚位置,从源头减少页码重复、错位,转完基本不用再一页页比对。
软领是知名国产软件品牌,20 年技术沉淀、服务千万用户,安装包在软领官网 wyouhua.com 直接下载,安装过程没有捆绑勾选项。软件里可以点客服按钮联系真人客服,几百页的大文件转换碰到麻烦也有人帮你看。
方法3 清掉转换带进来的分页符
转换常在每页底部硬插一个分页符,Word 再按自己的规则排一次版,页码就串位了。把多余分页符清掉,页码往往自己就归位。
操作步骤
- Ctrl+H 打开查找和替换,查找内容填 ^m(手动分页符),替换为留空,点全部替换
- 再查找 ^b 清分节符;替换前先在开始选项卡里打开显示编辑标记,看清分页符到底在哪
- 替换后看总页数有没有变小、页脚数字有没有重新排,说明确实清掉了多余分页
- 连续替换两遍,转换留下的往往是多重分页符,一遍清不干净

替换完记得滚到原来看起来最乱的那几页确认一下,分节符没清干净时,页码会从中间某页重新从 1 计数。
方法4 在 Word 里重建页码
删掉旧页码之后,要用 Word 自己的页码域重新插入,手打的数字早晚会错。页码域会随内容自动重算,改完正文也不用手动调。
操作步骤
- 插入-页码-页面底端,选居中或外侧,确认位置和原 PDF 对得上
- 双击页脚进入编辑,先把残留的文本框和手打的旧数字删干净再插
- 封面不要页码:页眉和页脚工具-设计,勾选「首页不同」
- 正文从 1 开始:页码-设置页码格式,起始页码填 1,必要时用分节符断开关联
如果页脚一直改不动,多半是当前节还挂在上一节上,取消「链接到前一节」再设一次就行。
方法5 逐页对照后另存 docx
每页首行文字一致,页码基本就对上了,最后另存为 .docx 再编辑。对照这一遍只看每页的分页位置和源文件是否一致,看首行文字就能判断,不用逐字校对。
操作步骤
- 视图-并排查看,把 Word 和源 PDF 摆在一起,从第一页开始比每页首行文字
- 首行一致页码基本就对;对不上说明还有分页符残留,回到方法3 再清一遍
- 目录页右键-更新域-更新整个目录,让目录页码跟着正文走
- 确认无误后另存为 .docx,以后编辑排版的偏移会更小

几百页的文件不用每页都看,抽头一页、中间一页、最后一页核对,页码连续且目录刷新正常就算过关。
常见问题
PDF转Word后页码变成 1、1、2 是怎么回事?
多半是转换时在每页底部插入了手动分页符,页脚又重复了一份。先在 Word 里用 Ctrl+H 把 ^m 全部替换掉,再检查页脚有没有多余的文本框。
转换后每一页页脚都是同一个页码,怎么改回来?
这通常是页码被做成了固定文本框,不是会自增的页码域。双击页脚删掉旧内容,用插入-页码-页面底端重新插一次就好。
PDF转Word页码和目录对不上,能批量修吗?
页码可以用页码域自动重排,不用逐条手改;目录页右键-更新域-更新整个目录,目录数字会跟着正文页码一起刷新。
Word 里用 Ctrl+H 替换 ^m 清了分页符,页码还是乱的怎么排查?
再看 ^b 分节符和多余空段落,分节符会让页码重新计数;另外确认页脚的「链接到前一节」状态,必要时用插入-页码-设置页码格式重设起始值。
几百页的 PDF 转 Word,怎么避免页码错位?
按页码范围拆成每份 30 到 50 页分别转,文件名带上范围编号,转完再拼合统一检查页脚数字是否连续,比整本一次转的重做成本低得多。
推荐阅读
PDF怎么编辑修改文字 先判断扫描件能否选中文字再决定要不要OCR
pdf加密码后文字选不中,是权限限制还是临时故障?按顺序排查
相关推荐
PDF文件加密怎么解除打印?先分清打开密码还是权限密码再处理
 pdf转word乱码修复pdf转word页码错位pdf转换页码修复软领PDF阅读转换器



 提示