



 有用科技小编2026/11/22
 浏览9777
 阅读14分钟
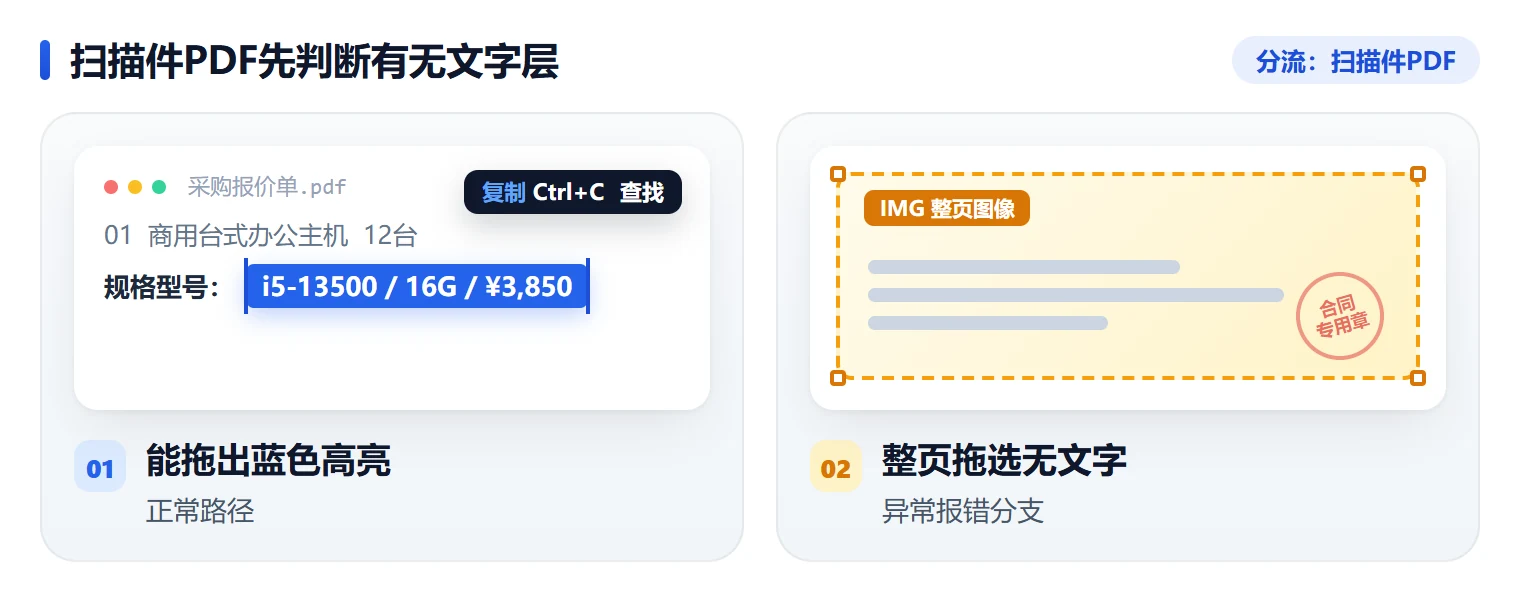
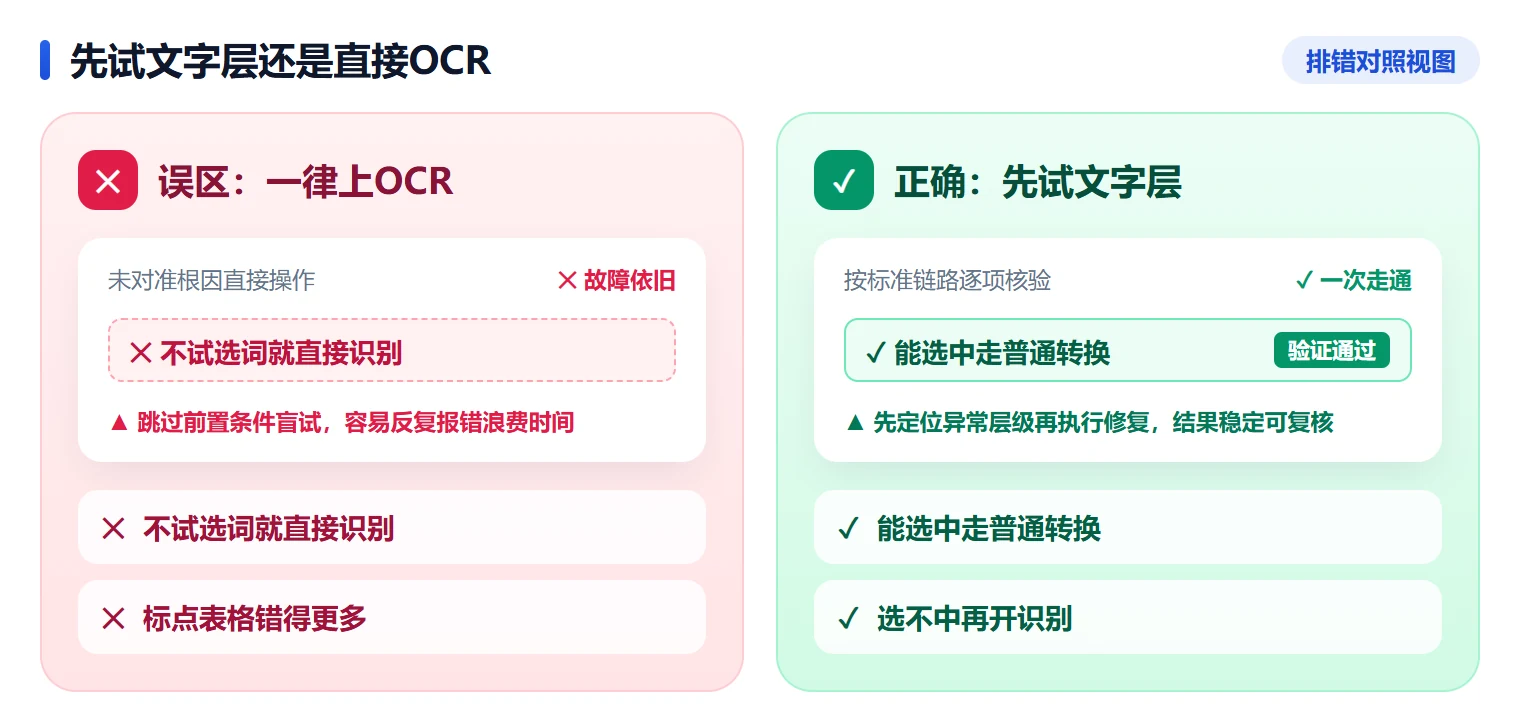
扫描件PDF转Word之前先做一件事:在页面上拖选文字,或者按 Ctrl+A 全选后复制,能拖出蓝色高亮、粘到记事本里是正常汉字,说明这份文件有文字层,直接按普通PDF转Word走;整页都选不中、粘出来只有空白或方块,再打开OCR识别把图片上的字认出来。
多数扫描件转不出文字,是页面本身只有一层图片,没有可提取的文字层,再碰上识别语言选错、一次转的页数太多,最后拿到的docx才会是图片或者乱码。文件本身大多没坏,按顺序排查一遍就能拿到能编辑的Word。
适用系统:Windows 10 / Windows 11;最后更新:2026-11-22。
扫描件PDF转Word前,怎么判断要不要先过文字层?
最常见的现场是这样:文件能打开、能翻页,但无论怎么拖鼠标都出不来蓝色高亮,按 Ctrl+A 再粘到记事本里是一片空白;转成 docx 之后,每一页在 Word 里都是一张整页图片,点上去只会出现图片的边框控制点。这种情况说明屏幕上看到的字其实是像素,得先让软件把像素认成文字,才能谈排版和校对。
| 具体现象 / 位置 | 常见原因 | 建议直接看 |
|---|---|---|
在PDF页面拖选文字 / 按 Ctrl+A 复制 | 判断这份PDF到底有没有文字层 | 能拖出蓝色高亮看第2步;整页选不中看第3步 |
| 有文字层的电子版PDF,可复制、可搜索 | 文字本身就是字符,不需要识别 | 别多此一举开识别,识别反而会改错字、丢排版 |
| 扫描件、拍照件、传真件,纯图片 | 只有像素没有文字层 | 必须打开OCR文字识别,否则转出来是一页页图片 |
| 中英混排的合同、发票、说明书 | 识别语言选错会整页乱码 | 识别语言选“中文简体”或“中英混合”,先只转前3页试效果 |
| 几百页的大扫描件,或者转换中途卡住 | 体积大、单次任务超时容易漏页 | 按页码分批转,每次30到50页,转换时不要关窗口 |
先判断有没有文字层,再决定用哪种转换方式,后面每一步设置才有意义。
第1步 先用拖选文字判断这份PDF有没有文字层
这一步只做一件事:确认PDF里装的是真文字还是整页图片,它决定你后面走普通转换还是走识别。
步骤 1:打开文件,按住鼠标拖选一行文字
用PDF阅读器打开这份文件,从某行文字的左上角按下去,拖到右下角松开。页面出现蓝色高亮,说明这一页有文字层。
步骤 2:全选复制,粘到记事本里验证
按 Ctrl+A 全选,再按 Ctrl+C 复制,切到记事本按 Ctrl+V 粘贴。粘出来是正常汉字,说明有文字层;粘出来是空白、方块或者一串问号,说明页面上只是图片。
步骤 3:放大到 400% 看文字边缘
把页面放大到 400%,看笔画边缘有没有锯齿、发灰、扫描阴影和轻微倾斜。有这些特征,基本可以判定整页是扫描出来的图片。
步骤 4:看左侧缩略图找扫描痕迹
左侧缩略图里整页像照片、带装订孔和折痕、页边不齐,都是典型的扫描件特征。拍照件还会留下桌面背景和手指阴影。
步骤 5:记下结论,决定走哪条路
能选中文字,走第2步的普通PDF转Word;整页选不中,走第3步打开OCR识别。这一步花不到一分钟,能省掉后面反复重转的时间。
用「软领PDF阅读转换器」自动识别文字层并一键转出可编辑Word
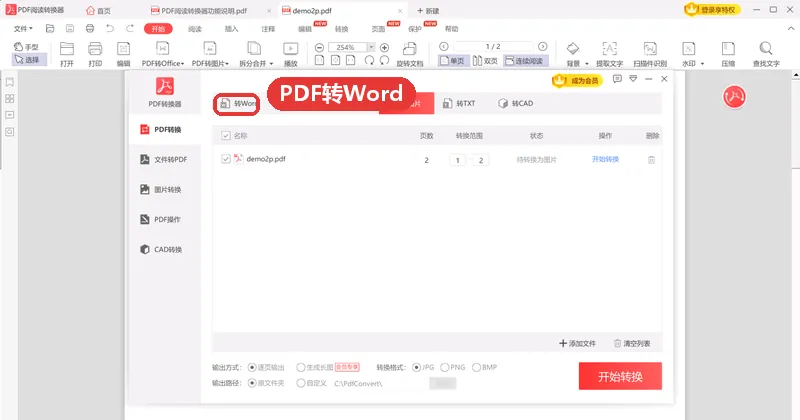
「软领PDF阅读转换器」的 PDF转Word 把电子版和扫描件收在同一个转换入口里:页面里有真实文字层的,按文字直接提取;整页是图片的,走识别把图像转成文字。这样就不用手动试选、也不用在两套流程之间来回折腾,转出的 docx 会尽量保留原有的段落、表格和分页。
「软领PDF阅读转换器」出自软领,软领是知名国产软件品牌,做了20年工具软件,服务过千万用户。软件在软领官网 wyouhua.com 直接下载,安装过程没有捆绑勾选项;软件里点客服按钮就能联系真人客服,碰上带表格和印章的复杂文件,也可以让工程师远程协助看一遍。
第2步 有文字层的PDF直接走PDF转Word
既然确认了文字层是真的,直接转就行,不要勾选识别开关,识别会把本来正确的字符认成错别字。
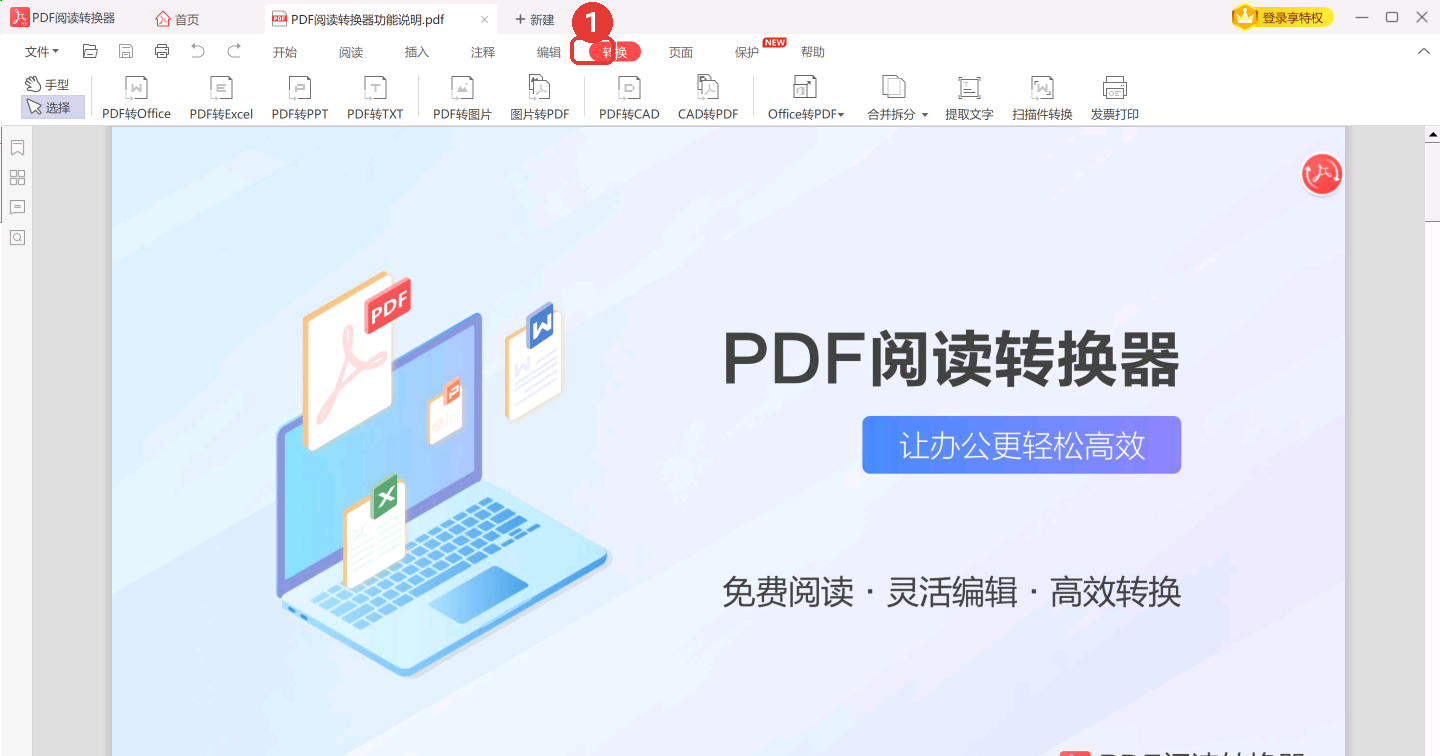
步骤 1:打开软件,点顶部「转换」标签
打开「软领PDF阅读转换器」,点顶部的「转换」标签,PDF 转 Office 这类入口都在这一栏里。
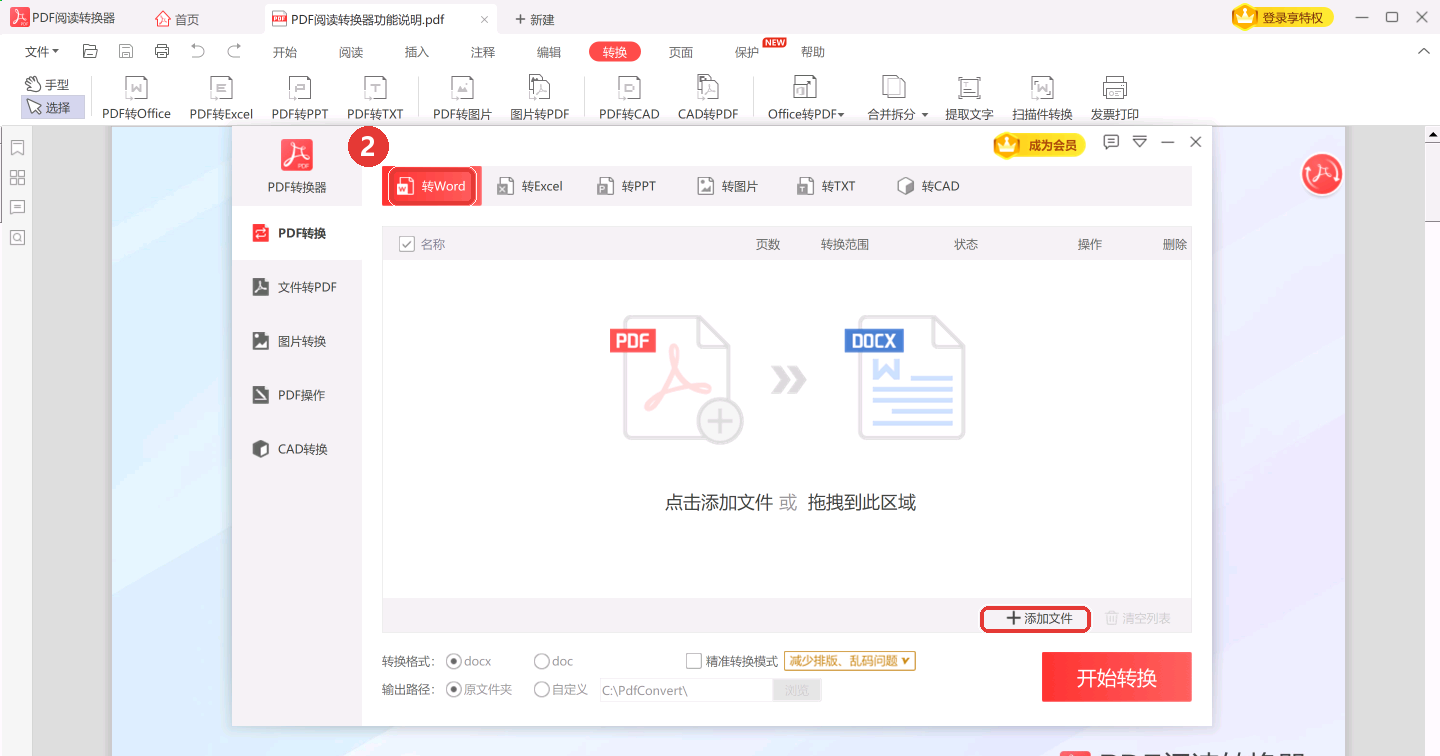
步骤 2:选中「转Word」,添加文件
在转换类型里选中「转Word」,再点右下角的「添加文件」,把要转的PDF加进来。
步骤 3:输出格式选 docx 或 doc
要保留较新排版,选 docx;文件要发给还在用老版本 Word 的同事,就选 doc。
步骤 4:确认文件列表和输出目录后点「开始转换」
核对文件列表和输出目录,点「开始转换」。转换期间不要关窗口,也别切走去做视频导出这类吃内存的事。
步骤 5:打开转出的文件翻一遍
转好的 docx 默认和源文件放在同一个文件夹里,先打开翻一遍,再决定要不要继续处理下一份。
注意
输出目录里已经有同名 docx 时会被直接覆盖。转换前先看一眼目录,或者改一个输出路径,把旧的成果挪开。
第3步 选不中文字就用OCR识别把扫描件转成Word
扫描件必须打开文字识别开关,并且选对识别语言和页码范围,否则转出来要么还是图片,要么整页乱码。
步骤 1:同样在「转换」→「PDF转Office」里选「转Word」
先点「添加文件」把扫描件PDF加进来。这一步和第2步的入口是同一个,区别只在后面有没有勾识别。
步骤 2:打开「OCR文字识别」开关
在转换设置里打开「OCR文字识别」,部分版本叫「识别图片文字」。不打开,软件只会把每一页当成图片贴进Word。
步骤 3:识别语言选「中文简体」或「中英混合」
纯中文文件选「中文简体」;中英混排的合同、说明书选「中英混合」。语言选错,会出现整页乱码和成片的问号方块。
步骤 4:页数多时先用页码范围试前 3 页
加好的PDF会列在转换列表里,页数多的时候先在页码范围里只填前 3 页,确认识别质量再整篇转。这样试错成本最低。
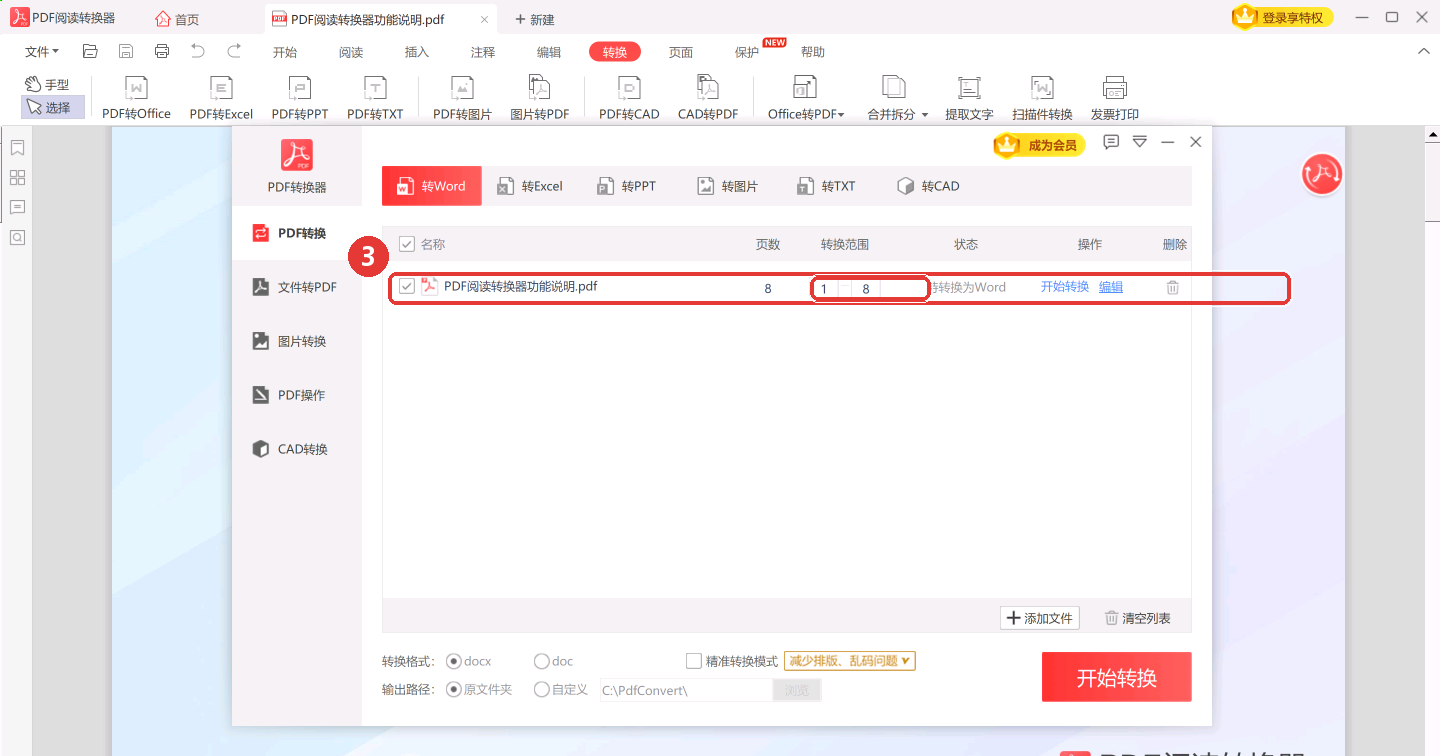
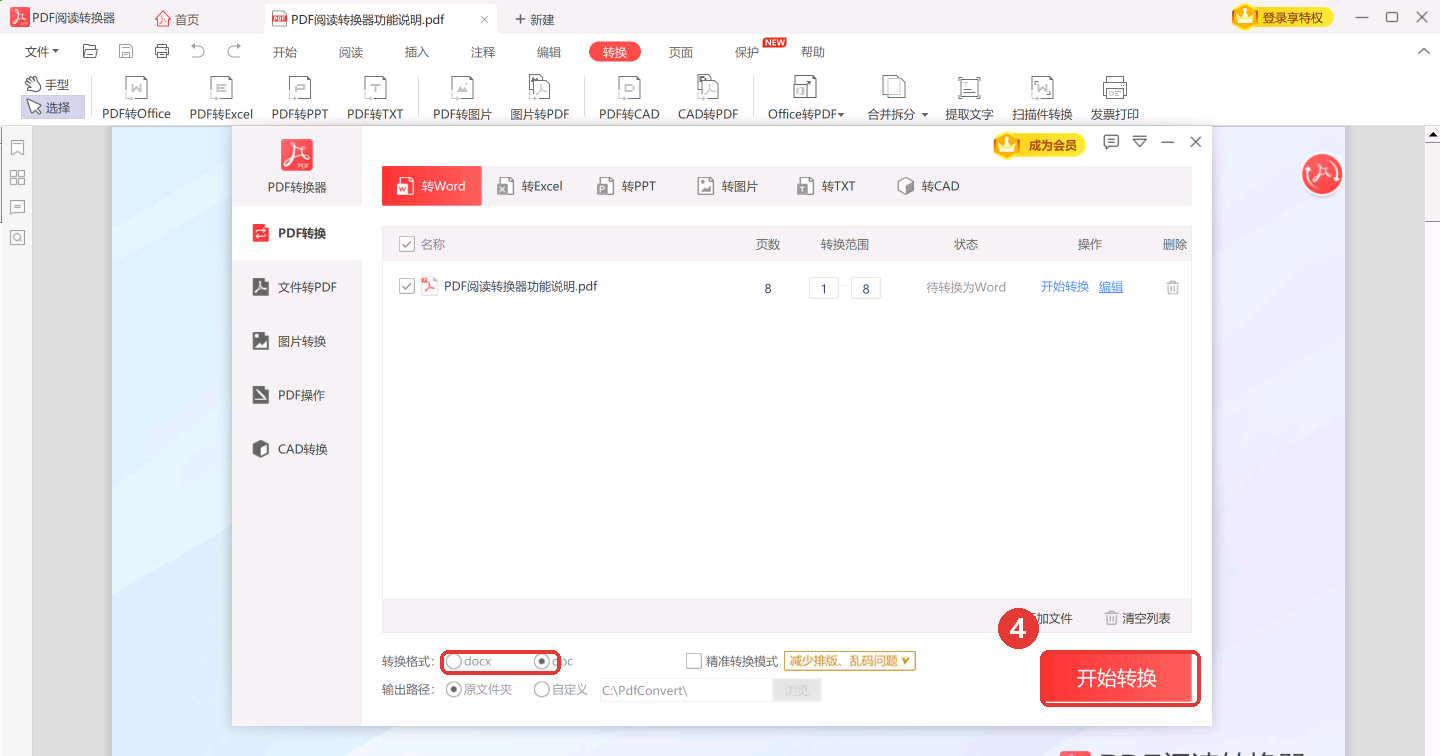
步骤 5:输出格式选 docx,点「开始转换」
识别一张 A4 大约要几秒,页数多时耐心等进度条走完,中途不要关窗口。
第4步 打开Word逐页校对识别排版与错字
识别出来的文字一定带错,排版也会走形,这一步决定文件是直接能用还是得重来。
步骤 1:先确认总页数没有缺
打开转出的 docx,按 Ctrl+End 跳到最后一页,先看总页数是不是和原PDF对得上,有没有整段整页丢失。
步骤 2:重点查表格、分栏和页眉页脚
看表格线有没有错位串格、分栏有没有并成一大段、页眉页脚和页码有没有跑进正文里。这三处是识别排版最容易走形的地方。
步骤 3:扫一遍容易认错的字符
识别最常把 0 认成 O、把 1 认成 l,还会混掉句号和间隔号、全角半角标点。金额、编号、型号这类位置要逐字对。
步骤 4:检查图片、印章和公式
确认图片、印章、签名有没有丢,公式、上下标、项目符号还在不在原位。缺了的,从原PDF里重新截取贴回对应位置。
步骤 5:另存为新文件名
改完点「文件」→「另存为」,存成一个新文件名,把原始 docx 留着,方便和原PDF二次对照。
第5步 转换失败或结果异常时的排错
转出来是图片、乱码、漏页、卡进度,原因基本固定,按现象对号入座就行。
步骤 1:转出来全是一页页图片
说明 OCR 开关没打开。回到第3步勾上「OCR文字识别」,重新转一次。
步骤 2:整篇乱码或大量问号方块
识别语言选错了。改成「中文简体」或者「中英混合」,把原来那份文件重转一遍。
步骤 3:两百页只出来二十页
单次任务太长容易超时漏页。按页码范围分批转,每次30到50页,转完一批接着下一批。
步骤 4:点「开始转换」没反应或卡在进度条
先关掉同时打开的PDF、Excel这类软件,把源文件复制到桌面再转,文件路径里别带特殊符号。
步骤 5:提示文件受保护或无法读取
先在阅读器里用它打印成一份新PDF,再拿这份没有保护的副本去转。
步骤 6:扫描件太糊,识别率很低
从源头重新扫描,分辨率设 300dpi 以上,页面摆正再转。清晰度不够,后面怎么调都提不上来。
大家常问
扫描版pdf转word后全都是乱码问号怎么办?
九成是识别语言选错了。回到转换设置,把识别语言改成「中文简体」,中英混排的文件选「中英混合」,先在页码范围里只填前3页验证效果,确认没问题再整篇重转一次。
扫描件PDF用OCR转Word,识别语言选错了整页变乱码还能补救吗?
能,原PDF没有被改动,重新转一次就行。把同一份源文件再添加进转换列表,改对识别语言后覆盖输出,之前那份乱码的 docx 不用手工去修。
300多页的扫描PDF转Word总是漏页、卡在进度条不动,要分批转吗?
要分批。在页码范围里每次填30到50页,转完一批接着下一批;转换期间不要关窗口,也别同时开PDF、Excel这类占内存的软件。
PDF里文字能选中但复制出来是问号,这份算有文字层还是扫描件?
这种多出现在文字层的字体编码上,页面里仍有可提取的字符。先确认PDF用的中文字体本机装没装;实在粘不出来,就打开「OCR文字识别」按扫描件的办法再转一次。
扫描的PDF里有表格和公章,转成docx后表格线全没了怎么处理?
表格线属于识别排版,转换时尽量选 docx,转完在Word里对着原PDF重画框线。公章、签名这类彩色图元识别不出来,从原PDF里截图贴回对应位置更稳。
推荐阅读
相关推荐
 扫描版pdf转word扫描pdf怎么转换成word文档PDF文字层识别软领PDF阅读转换器





 提示