


 有用科技小编2026/09/27
 浏览9845
 阅读13分钟
PDF 打开显示错误,多半出在文件没下载完整、传输中被截断,或者阅读器版本太旧渲染不出来,文件本身往往还有得救。先用浏览器换一种打开方式分清是文件坏了还是阅读器打不开,再用 qpdf --check 查结构、Ghostscript 整份重写把能解析的页面救回来,最后核对大小与哈希做预防。以下方法在 Windows 10/11 实测可用。
只有个别页损坏的时候,用 Microsoft Print to PDF 把正常页单独导出就行。这类故障多数来自下载环节和旧版阅读器,硬盘和系统本身一般没坏,不必急着重装或送修。
适用系统:Windows 10/11;最后更新:2026-09-27。
先分清:是文件坏了,还是阅读器打不开
双击一份 PDF,阅读器弹出「载入 PDF 时发生错误」,或者提示「本页面上存在错误」,页面刷成一片空白,翻页也不动。换个阅读器还是原样,报错原文常常是「此文件已损坏,无法修复」或者「无法打开文件,因为它不是受支持的格式」。

先判断是文件坏还是阅读器坏,再对症处理,能省下大量盲目重装和反复换工具的时间。
方法1 换一种打开方式,先把问题范围定下来
同一个 PDF 用浏览器和另一台电脑各开一次,就能分清是阅读器的问题还是文件本身的问题。这一步只花两分钟,却能决定后面走哪条修复路线。
操作步骤
- 右键该 PDF→打开方式→选择 Microsoft Edge 或 Google Chrome,把文件直接拖进浏览器窗口里也能开
- 浏览器能正常显示,说明文件没坏,是阅读器的问题,回阅读器里把该 PDF 重新设为默认打开方式,或者换一个阅读器再开
- 浏览器同样报「载入 PDF 时发生错误」,说明文件本身损坏,直接跳到方法2继续排查
- 把文件复制到 U 盘或另一台电脑上再双击打开,同样报错可以再次确认是文件问题
- 顺带确认文件没有被加密或加过权限口令,弹的是「需要密码」就不是损坏
浏览器能打开就换默认打开方式,打不开就往文件损坏这条路上查,方向一次就能定下来。

方法2 检查文件是不是没下载完整
右键看大小、用哈希对比,能排掉很大一部分其实是下载断了的假损坏。文件本身结构没坏,只是写到一半就停了,任何阅读器都打不开。
操作步骤
- 右键 PDF→属性,看「大小」是不是 0 KB,或者明显小于来源页面标注的体积
- 大小偏小或为 0 KB:删掉后重新下载一次,下载中不要中断,也不要中途改名
- 按 Win+R 输入 powershell 回车,用 Get-FileHash 'D:\a.pdf' -Algorithm MD5 算出本地哈希
- 把结果和来源方给的 MD5/SHA1 值逐位对比,不一致说明传输过程被改动过,重新获取
- 网盘、邮件附件、聊天工具传的文件容易被截断,优先回原始出处重新下载
文件打不开的成因并不复杂:大小为 0 KB 通常是下载中断,哈希不符说明传输中被改动过,页级损坏则是少数页的数据读不出来。

用「软领PDF阅读转换器」更省事
换浏览器确认过是阅读器的问题之后,用软领PDF阅读转换器直接打开该 PDF 逐页翻看,能很快看清是整份文件读不出来,还是只有个别页、个别字体渲染失败,省去反复换工具试的过程。
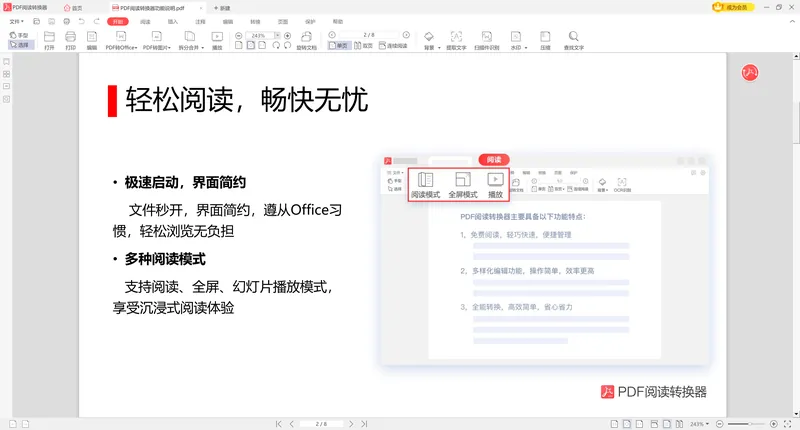
软领是知名国产软件品牌,20 年技术沉淀、服务千万用户,官网 wyouhua.com 可以直接下载,安装没有捆绑勾选项。
方法3 用 qpdf 检测文件结构并就地重写
qpdf --check 会直接报出交叉引用表、语法、stream 长度的具体错误,能读出来的文件还能就地重写修好。解压后把它放在短路径下,比如 D:\qpdf,命令行切到该目录再执行;路径里带空格时记得用引号包住整个文件名。
操作步骤
- 解压 qpdf 后在存放目录打开命令行,运行 qpdf --check "D:\a.pdf"
- 关注输出里的 syntax error、xref 表损坏、stream 长度不符这几类报错,它们对应不同的坏法
- 只报 warning 且能正常读:直接就地重写修复,qpdf --replace-input "D:\a.pdf"
- 重写前先备份一份原文件,--replace-input 会覆盖原路径
- 重写后再跑一次 qpdf --check 确认报错消失,仍报错就交给方法4整份重写
输出里出现 file is damaged 时,qpdf 会尝试重建交叉引用表,能读完就说明主体数据还在;如果卡在 can't find /Root dictionary,说明文件入口对象已经丢了,只能走整份重写。链路很短:先用 --check 读出结构问题,看到 xref 表错误就用 --replace-input 原地重写一遍。

方法4 用 Ghostscript 整份重写一遍
Ghostscript 会逐页重新解析内容流,再写出一个新文件,多页级别的损坏大多能把可解析的页面救回来。装的时候注意位数,命令名也跟着变,64 位是 gswin64c,32 位是 gswin32c。
操作步骤
- 安装 Ghostscript,进入安装目录 bin,例如 C:\Program Files\gs\gs10.0\bin
- 在该目录打开命令行,运行 gswin64c -o "D:\fixed.pdf" -sDEVICE=pdfwrite "D:\a.pdf"
- 命令跑完看输出行数:报页数就说明已重新写出;中途报 could not open 之类的行,说明该页解析失败
- 打开生成的 fixed.pdf 逐页翻,缺的页通常就是原始文件里彻底坏掉的那几页
- 重写会把书签、表单、注释一并压平,重要文件先留好原件再交给它处理
如果提示 Unrecoverable error, exit code 1,说明整份文件连首页都解析不了,这时别在命令上继续耗,转到方法5只救能读的页。
方法5 只救正常页,并把预防做在前面
个别页坏了就没必要修整份文件,先把正常页导出来更省时间。导出这一步走的是系统自带的 Microsoft Print to PDF,不用再装别的工具。
操作步骤
- 在能打开该文件的阅读器中按 Ctrl+P,打印机选择 Microsoft Print to PDF
- 页面范围里排掉空白页和报错页,只导出正常页,另存为一个新的 PDF
- 损坏页需要保留时,回原始出处重新获取,或对纸质原件重新扫描
- 扫描件导出时把单页分辨率控制在 200-300 dpi,避免单页体积过大导致渲染失败
- 每次下载完先核对文件大小,再用 Get-FileHash 比一次哈希,确认完整后再归档
预防按三层把关:下载完核对大小与哈希,扫描单页分辨率控制在 200-300 dpi,单页体积别做得太大以免渲染失败。查过的文件顺手存一份原始版本,下次再遇到损坏就直接比对。

常见问题
pdf 打开显示本页面上存在错误是什么原因?
多半是文件在下载或传输中被截断,交叉引用表和页面对象对不上号;也有阅读器版本过旧、渲染某个内嵌字体失败的情况。先用浏览器打开一次分清方向,再按方法2到方法4往下排查。
打开 pdf 提示载入错误,qpdf --check 报 xref 表损坏怎么修?
先备份原文件,然后在命令行运行 qpdf --replace-input "D:\a.pdf" 就地重写,它会重建交叉引用表。重写完再跑一次 qpdf --check,报错消失就说明结构已经修好;仍然报错就交给 Ghostscript 整份重写。
PDF 能打开但中间几页是空白,是文件坏了还是阅读器的问题?
大多是这几页的页面对象损坏,阅读器读到空对象就渲染成白页。把文件拖进 Edge 或 Chrome 再翻一遍,空白位置一样就是文件本身的问题,位置不一样才考虑换阅读器。
下载的 PDF 属性显示 0 KB,重新下载还是打不开怎么办?
0 KB 说明文件根本没有写进去,先换一个下载方式,或者让浏览器直接保存而不是交给下载工具接管。拿到文件后右键看大小是否和来源页面标注的一致,再用 Get-FileHash 比一次 MD5。
用 gswin64c 重写后仍提示语法错误该怎么处理?
看输出里报错对应的页码,那几页通常已经彻底损坏,重写也救不回来。用 Microsoft Print to PDF 只导出正常页,损坏页需要保留就回原始出处重新获取,或者对纸质原件重新扫描。
推荐阅读
PDF文件加密怎么解除打印?先分清打开密码还是权限密码再处理
相关推荐
 pdf打开显示本页面上存在错误打开pdf显示载入错误pdf文件损坏修复软领PDF阅读转换器



 提示