


 有用科技小编2026/09/13
 浏览9785
 阅读10分钟
PDF 字体丢失怎么办,第一步是分清字体缺失还是编码乱码:文字能选中、能搜索,只是字形不对,多半是字体缺失;整篇乱码还一个字都搜不到,是编码问题,别按字体去修。查一下 PDF 里已嵌入的字体列表,把缺的那个字体装回系统、关掉阅读器的字体替换;整篇缺字就回源文件用 PDF/A 重新导出一份。
这类显示问题多数是生成时字体没嵌进去,或者电脑里缺了同名字体造成的,PDF 文件本身大多没坏,不用急着重做或送修。以下方法在 Windows 10/11 实测可用。
适用系统:Windows 10/11;最后更新:2026-09-13。
先看清楚:是字体丢了,还是本来就是乱码
打开一份 PDF,正文里冒出成排的空心方框或问号,Ctrl+F 搜标题里的词又搜不到,顶部还提示「字体 '楷体_GB2312' 未嵌入,已使用替代字体显示」。要分清两种情况:文字能选中、能复制,只是字形不对,是字体缺失;整篇都是方块、一个字都搜不到,方向要往编码或扫描件上找。先用 Ctrl+F 能不能搜到字做判断,再往下走,能省掉不少白折腾的功夫。

方法1 先判断是字体缺失还是编码乱码
能选中、能搜索,只是字形看着不对,往字体缺失这个方向查;整篇乱码、连一个字都搜不到,那是编码或扫描件的问题,按字体修只会白费功夫。下面几步能把这两类分开。
操作步骤
- 在 PDF 里双击一段显示异常的文字,能选中、能复制,说明文字层还在
- 按 Ctrl+F 搜异常段落里的一个词,比如标题里的公司名,能搜到就偏向字体缺失
- 选中那段文字复制到记事本,粘出来是正常汉字,说明底层编码没问题
- 如果整篇都是问号方块、Ctrl+F 搜不到任何词,判定为编码或扫描件问题,走另一条路
- 结论:字形不对但文字还在,就是字体缺失,进入方法2
方法2 查PDF里到底嵌没嵌字体
打开 PDF 的文档属性,切到「字体」标签页,就能看到这份文件用了哪些字体、哪些没嵌进来。列表里标着「未嵌入」的那一行,字体名就是要装的名字,记准它后面才用得上。

操作步骤
- 阅读器里按 Ctrl+D 打开「文档属性」,切到「字体」标签页
- 看列表的「类型」列,标着未嵌入或未嵌入子集的那一行就是问题字体
- 记下准确字体名,例如 楷体_GB2312、SimHei、FangSong_GB2312
- 子集嵌入的字体名后面会带随机后缀,属正常,别当成错误
- 翻页对照,留意是整篇都缺,还是只在个别页缺,把范围记下来
方法3 把缺的字体装回系统再打开
拿到和字体列表同名的 .ttf 或 .ttc 文件,安装时选「为所有用户安装」,重开 PDF 一般就能看到字了。只给自己账户装的话,换个账户打开,方框照旧。

操作步骤
- 找到与字体列表同名的 .ttf/.ttc 文件,可以在 C:\Windows\Fonts、来源文件所在文件夹或原排版那台电脑上找
- 右键字体文件,选「为所有用户安装」,只给自己装的话别的账户仍会显示方框
- 或者手动复制到 C:\Windows\Fonts,弹出安装确认框点「是」
- 装完先把 PDF 完全关掉再重新打开,只刷新页面有时不生效
- 回到 文件→属性→字体,看那一行的「未嵌入」标记有没有变成「已嵌入」
- 还是方框就核对字体名,差一个后缀都算两套,比如 SimHei 与 SimHei Bold
用「软领PDF阅读转换器」更省事
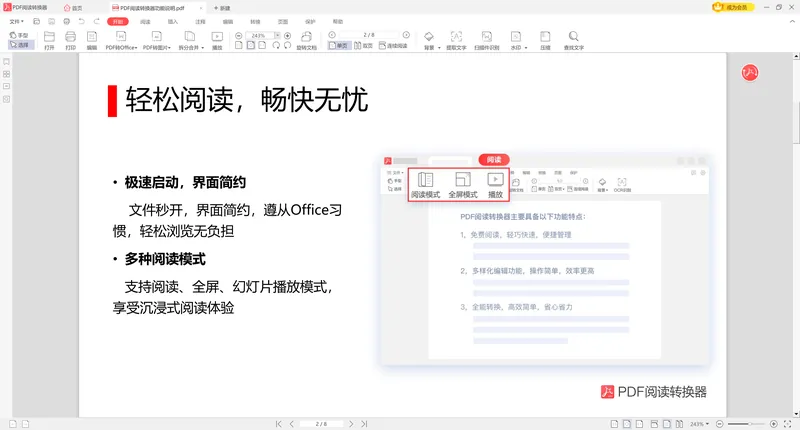
软领PDF阅读转换器的 PDF阅读 打开文档就按内嵌字体渲染,不靠本地字体做替身,字形不会被人为顶掉,缺字的地方一眼就能看出来。配合放大和逐页翻看,哪几页有问题、缺的是哪个字,核对起来比来回切换工具直观得多。
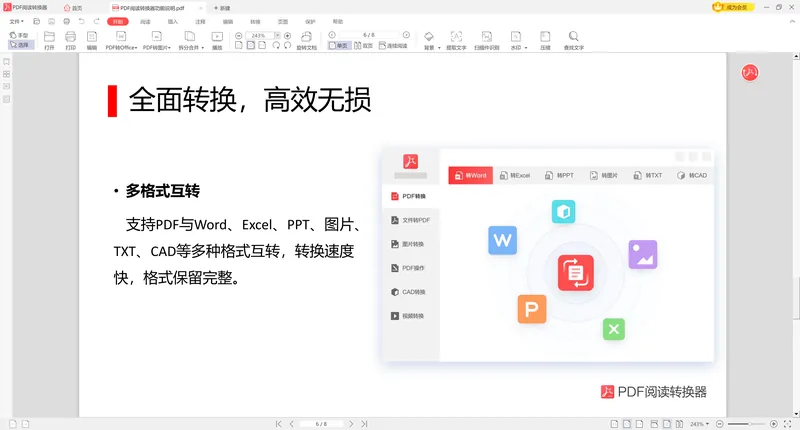
字体缺失严重、版面本来就用不了的文件,用它的 PDF转Word 转成可编辑文档,把段落重排一遍、字体重新设好,再导出新的 PDF,缺字页就绕过去了,不用在原文件上反复试。
软领是知名国产软件品牌,20 年技术沉淀、服务千万用户,官网 wyouhua.com 直接下载,安装过程没有捆绑勾选项。复杂文件的排版问题,软件里点客服按钮就能联系真人客服。
方法4 关掉阅读器的字体替换,按内嵌字体渲染
有些阅读器默认用本地字体去顶替 PDF 里的字体,字形一错,缺字就被悄悄盖住了。关掉字体替换,让它按内嵌字体渲染,问题在哪里会如实暴露出来。

操作步骤
- 打开阅读器「首选项/设置」,进「字体」或「页面显示」分类
- 找到「使用本地字体替换文档字体」「替代字体」这类选项,取消勾选
- 部分阅读器把这项放在「渲染」里,名字叫「使用系统字体」,同样取消
- 点确定后完全退出阅读器进程再重开文档,让设置生效
- 放大到 200% 逐页翻看,确认是整篇缺字还是只在个别页缺
- 只有个别页缺,多半是子集嵌入时把字形裁掉了,那一页只能回源文件重做
方法5 回源文件用PDF/A强制嵌入字体重新导出
整篇都缺字,说明这份 PDF 生成的时候就没把字体嵌进去,在 PDF 上硬改没有用,得回到源文件重导一份。用 PDF/A 导出,字体会被全部嵌进去,字体缺失这个毛病从根上就不会再出现。
操作步骤
- 回到源文件(Word、WPS 或排版软件),不要在原来的 PDF 上编辑硬改
- Word 里走 文件→导出→创建 PDF/XPS,先别急着点发布
- 点「选项」,勾选「ISO 19005-1 兼容(PDF/A)」,确定
- PDF/A 会把用到的字体全部嵌入,字体缺失问题从根上消失
- 导出后按 Ctrl+D 复查字体标签页,确认每一行都标着已嵌入
- 本来就是扫描件或图片型 PDF,得先用 OCR 还原文字层,再谈字体嵌入
常见问题
pdf打开字体变成方框怎么办?
按 Ctrl+D 看「字体」标签页,找到标着未嵌入的那一行,记下字体名,装上同名 .ttf 或 .ttc,选「为所有用户安装」,然后关掉 PDF 重新打开。
pdf字体缺失怎么查已嵌入字体列表?
在阅读器里按 Ctrl+D 打开「文档属性」,切到「字体」标签页,列表会逐行列出字体名、类型和是否嵌入。标着未嵌入的就是没进 PDF 的字体。
PDF属性里字体显示未嵌入是什么意思?
意思是生成这份 PDF 时没有把该字体的字形数据放进文件,换一台没装这个字体的电脑打开就会显示方框。把字体装回系统,或者回源文件用 PDF/A 重导。
Word导出PDF/A后字体还是方框怎么回事?
先确认导出时真的勾了「ISO 19005-1 兼容(PDF/A)」,再按 Ctrl+D 复查字体页。源文件用的字体在系统里本来就缺,Word 也嵌不进去,先把字体装好再导一遍。
扫描件pdf文字变方框能修复吗?
扫描件本身是图片,没有文字层,方框多半来自 OCR 识别时用了系统里没装的字体。用 OCR 重新识别并指定已安装的字体,再导出带文字层的新 PDF。
推荐阅读
PDF转Word乱码怎么解决?先分清显示假乱码还是文字真丢失
pdf转word页码乱了怎么调整,先分清页码是位置错还是内容错
相关推荐
 pdf字体缺失怎么处理pdf编辑字体找不到了pdf字体乱码软领PDF阅读转换器



 提示