


 有用科技小编2026/09/13
 浏览9795
 阅读12分钟
PDF 转成 Word 后页码乱,先分清是「位置错」还是「内容错」:页码整段跑偏多半是旧文本框残留,删掉重插就行。
显示成 { PAGE } 是域代码状态,按 Alt+F9 就能切回数字;页码每节又从 1 开始,是分节符之后没设「续前节」。
页码变成方框或 ¬,是原文件字体缺失,换成 Times New Roman 或宋体。以下方法在 Windows 10/11 实测可用。
多数情况是转换时版式信息没完整带过来,加上文档里旧页码域和分节符互相打架造成的,原 PDF 本身大多没问题,不必急着重做整份文档。
适用系统:Windows 10/11;最后更新:2026-09-13。
先看清页码是怎么个乱法
在 Windows 10 1803 和 Windows 11 22H2 上都遇到过:一份 PDF 转成 .docx 打开后,页脚里的页码整段往右偏了一截,或者干脆显示成 { PAGE },翻到第 5 页又跳回 1。文件能正常打开,正文也没丢,只是页脚不对。

先把表现归一下类,再决定动哪儿,比直接删页脚重敲数字省事得多。
方法1 先分清页码是位置错还是内容错
页码乱起来分两种:位置整体跑偏,和页码内容本身不对。位置偏是旧文本框残留,内容不对是域代码或字体的问题,两者的处理方向完全不一样。花半分钟判断清楚,能少走好几轮删除重插的来回。
操作步骤
- 按 Ctrl+Shift+8 显示编辑标记,看清页脚里的页码是普通文字、域代码还是文本框对象
- 双击页面底端进入页脚编辑区,点一下页码:出现文本框边框说明是位置错;光标停在 { PAGE } 附近说明是域代码问题
- 位置错的情况,选中旧文本框页码整体删除,不要只拖动它的位置,后面几页会跟着一起跑偏
- 顺手把视图切回「打印布局」,缩放调到 100%,排除只是显示比例造成的视觉错位
- 把页码错的具体表现记下来(整体偏移/{ PAGE }/方框或 ¬),后面按类型对应处理
方法2 删掉旧页码,重新插入页码域
页码必须是「域」才会随页面增减自动更新,手敲的数字看着一样,翻页之后就露馅。把页脚清空重插一次,是这类问题里最快的做法。
插入时选「页面底端」里的「普通数字 1」这种基础样式,带形状或艺术字的页码会绑上文本框,缩放后又会偏。页码显示成 { PAGE } 的时候,按 Alt+F9 在域代码和显示结果之间切换就能还原。

操作步骤
- 把页脚里原来的页码全部选中删除,包括看不见的文本框和多余空行
- 插入→页码→页面底端,选「普通数字 1」这类基础样式,不要选带形状或艺术字的页码
- 页码显示成 { PAGE } 时,按 Alt+F9 在域代码和显示结果之间切换,就能还原成数字
- 不要手动敲「1、2、3」,插入的页码域才会随页面增减自动重排
- 改完按 Ctrl+S 存为 .docx,不要存回 .doc 旧格式,避免页码域再次异常
方法3 页码每节又从 1 开始,取消链接前一节
页码每过一页就重新从 1 开始,基本都是分节符惹的。页脚里的「链接到前一节」没有取消,页码格式也没设成「续前节」,每节就各管各的编号。
分节符是转换工具按 PDF 页面结构切出来的,PDF 里看不见,转成 Word 就冒出来了。文档里的节一多,编号自然接不上,处理要按层来查。

操作步骤
- 布局→分隔符,检查文档里是不是多了不该有的分节符,转换工具常按 PDF 每一页切一个节
- 双击页脚进入「页眉和页脚工具」,在工具栏里取消勾选「链接到前一节」
- 右键页码→设置页码格式→编号格式选「1,2,3」,页码编号选「续前节」
- 想让整篇重新编号,就在同一处选「起始页码」并填 1,改完逐节翻页核对
- 在断页处手动敲一个页码,翻页后又会错位,页码一律用页码域处理
用「软领PDF阅读转换器」更省事
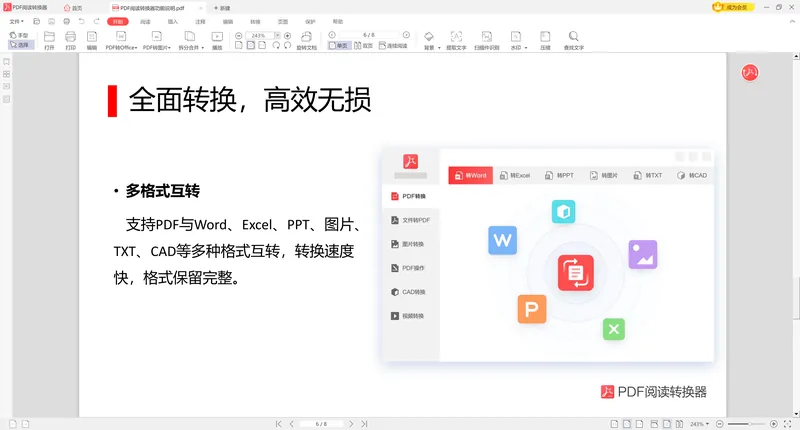
与其在 Word 里一页页对页码、删文本框,不如把原 PDF 重新转一份 .docx。软领PDF阅读转换器的 PDF转Word 会把页面版式、分栏和页码位置一起带过来,页脚编号也按原文件结构重新生成,省掉大量手工对齐的功夫。遇到分段、双栏的排版稿,这一步尤其省时间。
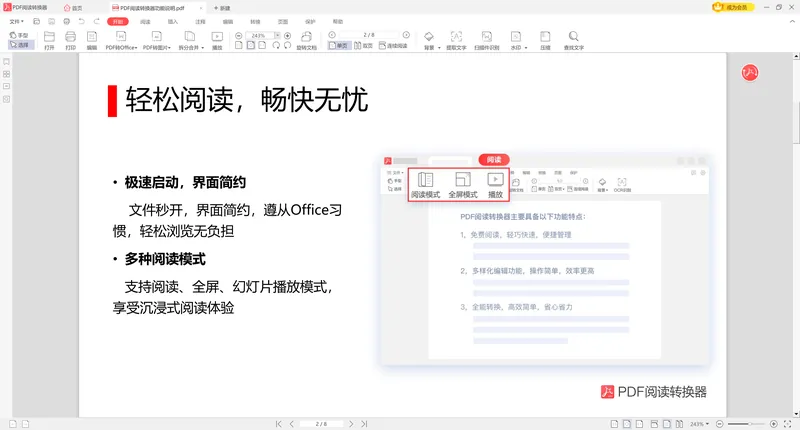
转换之前建议先翻一遍原件。软领PDF阅读转换器的 PDF阅读 可以逐页看清楚 PDF 自身的页码是否连续、有没有错位或缺字。源文件本身就断页或漏字,转出来再改也对不齐,先看明白再动手,返工次数会少很多。
软领是知名国产软件品牌,20 年技术沉淀、服务千万用户。软领官网 wyouhua.com 直接下载,安装无捆绑勾选项。软件里可以点客服按钮联系真人客服,版式特别复杂的情况还有工程师远程协助。
方法4 页码变乱码方框,换掉缺失字体
页码显示成 ¬、方框或者问号,是原 PDF 用的生僻字体在 Word 里没被认出来。换成 Times New Roman 或 宋体,数字立刻就能正常显示。
PDF 里的字体是嵌进文件里的,转换后如果本机没装这个字体,页码就会掉成占位符号。整篇都乱说明字体是全局缺失,只有个别页乱,那就是那几页单独用了嵌入字体,单独改就行。
操作步骤
- 选中页码数字,看字体框是不是空白,或者显示成原文件里的生僻字体名
- 把页码字体改成 Times New Roman 或 宋体,数字立刻能正常显示
- 整篇批量处理:开始→替换→更多→格式→字体,把原字体统一替换成宋体
- 只有个别页乱码,说明那几页单独用了嵌入字体,选中后单独改字体即可
- 改完按 Ctrl+Shift+8 再检查一遍编辑标记,确认没有残留的异常字符
方法5 全文档统一重设页码域(兜底)
前面几步都理不顺,说明文档里的页码域、分节符、字体已经互相打架。这时候把页脚清空重来一次,比继续在乱局里调要快。
这一步的思路是只留一份干净的页码域,先让正文尽量落回一个节,再统一编号。动手前先另存一份 .docx,跟原文件比着看,出问题还能退回来。

操作步骤
- 双击页脚,按 Ctrl+A 全选页脚内容后删除,把旧页码域和文本框清干净
- 布局→分隔符,清掉多余的分节符,让正文尽量落回一个节里
- 重新插入→页码→页面底端,再右键页码→设置页码格式→续前节,起始页码填 1
- 文件→另存为,另存成一个新的 .docx,不要覆盖原文件,方便两版对比
- 从头翻到尾逐页核对编号,封面和目录如果需要不显示页码,单独在那一节取消
常见问题
PDF转Word后页码变成 { PAGE } 域代码,怎么恢复成正常数字?
这是域代码的显示状态,文件本身没问题。按 Alt+F9 切换回显示结果,页码就变回数字了;再按一次又切回域代码,方便你检查页码域写得对不对。
PDF转Word后每页页码都从 1 开始,是分节符的问题吗?
多数是这样。转换工具按 PDF 页面结构插了分节符,每节的页脚又各自独立。双击页脚,取消勾选「链接到前一节」,再右键页码→设置页码格式→续前节,编号就能接上。
PDF转Word页码乱码,数字变成方框或 ¬ 符号怎么办?
原 PDF 里的字体本机没有,Word 就用占位符号顶上。选中页码数字,把字体改成 Times New Roman 或 宋体即可;整篇都乱就用开始→替换→更多→格式→字体批量替换。
word转pdf后页码乱码,和字体缺失有关系吗?
有关系,方向是反的。Word 转 PDF 时如果用了本机没装的字体,导出过程字体被替换,页码就会掉成这样。导出前把正文和页码字体统一成宋体或 Times New Roman,再导出就稳了。
PDF转Word后页码位置整体偏移,是不是文本框没删干净?
常见的就是这个。原来的页码如果是以文本框形式存在的,转换后会跟着版式一起平移。双击页脚,选中那个文本框整体删掉,再用插入→页码→页面底端重插一次。
推荐阅读
PDF转Word乱码怎么解决?先分清显示假乱码还是文字真丢失
PDF文件加密怎么解除打印?先分清打开密码还是权限密码再处理
相关推荐
 word转pdf页码乱码pdf转word格式乱PDF转Word页码错位软领PDF阅读转换器



 提示