

 有用科技小编2026/10/14
 浏览9832
 阅读11分钟
PDF转Word后表格变成一张图、点不进单元格,多数是原文件没有文字层,或者转换时整页被当成图片输出。先按 Ctrl+F 搜一下表格里的字:搜得到就走复制加选择性粘贴,搜不到只能用 OCR 兜底;已经转出表格但行列错乱的,用「表格转文本」再经 Excel 分列拉回正轨。以下方法在 Windows 10/11 实测可用。
这类情况大多是文件本身或者转换模式的问题,原文档一般没坏,不用急着重做表格或者手工敲一遍。
适用系统:Windows 10/11;最后更新:2026-10-14。
转完为什么表格成了一张图
最常见的现场是这样:文档在 Word 里打开,表格那块是一整张灰色图片,鼠标点上去只出现图片控制柄,进不去任何一个单元格,右键菜单里只有「另存为图片」和「设置图片格式」。再按 Ctrl+F 搜表格里的表头文字,Word 右下角提示「找不到匹配项」。换 Acrobat 或者 WPS 打开原 PDF 也一样,说明跟用哪个阅读器没关系。

先弄清自己的文件属于哪一种,再挑对应的方法处理,能省掉反复重转和手工重建表格的时间。
方法1 用Ctrl+F判断这份PDF有没有文字层
结论先给:搜得到表格里的词,就是文本型 PDF,后面的路好走;一个字都搜不到,就是图片或扫描件,只能走方法5。这一步花不了一分钟,却决定了后面要不要折腾转换模式。
文本型和图片型的 PDF 在屏幕上看长得差不多,肉眼分不出来,所以这一步别跳过。
操作步骤
- 用任意 PDF 阅读器打开文件,翻到表格所在的那一页
- 按 Ctrl+F 调出查找框,输入表格里的一个词,比如表头文字或者某个单元格里的数字
- 能搜到并高亮跳转,说明有文字层,属于文本型 PDF,继续看方法2
- 搜不到、提示「找不到匹配项」,说明这一页是图片或者扫描件,直接跳到方法5
- 顺手看一眼文档属性里的字体是否嵌入,嵌入的字体通常意味着有文字层
方法2 文本型PDF用选择性粘贴搬表格
结论:文本型 PDF 别整篇转,框选表格复制后在 Word 里用选择性粘贴,结构反而更稳。整篇转换会把页眉页脚、分栏、水印一起带进来,表格经常被拆得七零八落。
框选的时候范围尽量只包住表格本身,上下多带一行都可能把正文混进来。拿到纯文字后手工补边框,比回头去修一张错版表格快得多。
操作步骤
- 在阅读器里框选整张表格,按 Ctrl+C 复制
- 回到 Word,点「开始」→「粘贴」下面的下拉箭头→「选择性粘贴」
- 选「无格式文本」拿到纯文字,或者选「HTML 格式」尽量保住表格结构
- 走无格式文本的:选中这段文字→「插入」→「表格」→「文本转换成表格」
- 分隔符选「制表符」,列数按实际填写,确定
- 再套「表格工具」→「设计」里的边框样式,把表格线补回来

方法3 重新转换时切换输出模式
结论:同一份 PDF 分别按「偏版面」和「偏流式」各转一次,哪一份的单元格点得进去就用哪一份。不同工具对表格的处理差别很大,同一套设置也未必对每一页都合适。
两份文件并排点一遍表格最直观,能点进去、能框选文字的那份留下,另一份删掉就行。
操作步骤
- 回到转换工具,重新导入原始 PDF,不要拿上一次转出来的文件再转一次
- 输出模式选「偏版面/保持原样」转一次,另存为 A.docx
- 再选「偏流式/可编辑文字」转一次,另存为 B.docx
- 两份都打开,点一下表格单元格:能进单元格、能框选文字的那份才可用
- 两份都变成图片,检查是不是勾了「以图片输出」或者「扫描件模式」
- 转换前不要先拼页、压缩或者加密 PDF,这些操作容易把文字层丢掉
用「软领PDF阅读转换器」更省事
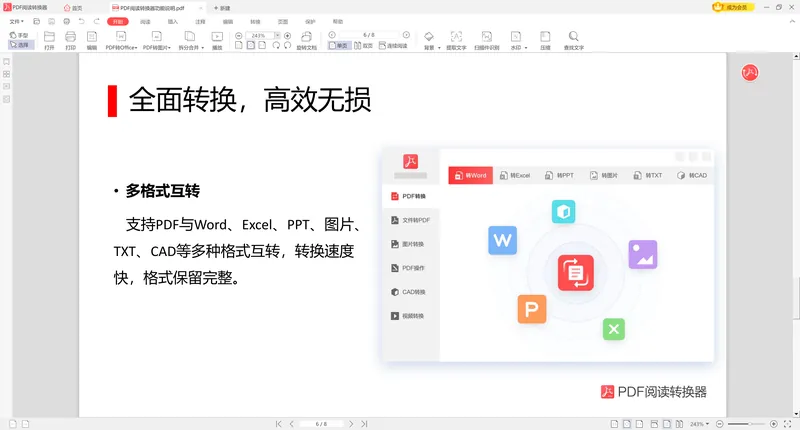
PDF转Word是软领PDF阅读转换器里的核心功能,它把 PDF 直接转成可编辑的 Word 文档,表格能点进单元格、文字能框选,省掉反复试转换模式和手工重建表格的折腾。导入文件、选好输出格式、点转换,出来的 docx 用 Word 打开就能改,做表格汇总和二次编辑不用返工。
软领是知名国产软件品牌,20 年技术沉淀、服务千万用户。软领官网 wyouhua.com 直接下载,安装无捆绑勾选项,文件在本地处理,不用先传到别人的服务器上。
方法4 版式错乱的表格先转文本再分列
结论:转出来是表格但行列全乱、一个单元格里塞着一堆空格的时候,先把它拆成文本,再用 Excel 分列对齐,比在原表格里逐格挪快得多。
分列做完列宽可能不齐,先把列宽拉好再复制回 Word,省得回头再调一次。
操作步骤
- 在 Word 里选中整张表格,点表格左上角的十字箭头图标
- 「表格工具」→「布局」→「数据」→「转换为文本」
- 分隔符选「制表符」,确定,表格散成一行行文字
- 全选复制,粘到 Excel 的 A1 单元格
- 用「数据」→「分列」→「分隔符号」,勾选「制表符」
- 行列对齐后再复制回 Word,重新「文本转换成表格」并加边框

方法5 图片型PDF只能靠OCR兜底
结论:没有文字层就没有捷径,只能先识别成文字再逐字校对。识别结果总会有认错的地方,数字、小数点、单位和符号最容易出错,识别完必须人工过一遍。
扫描件本身的清晰度决定了识别上限,原稿越模糊,错字越多。
操作步骤
- 确认方法1里 Ctrl+F 确实搜不到,整页就是扫描图或者截图
- 把 Word 里那张整图右键→「另存为图片」,留一份清晰版本
- 用 OCR 工具或者 Word 的「图片转文字」功能识别,输出为纯文本
- 识别结果粘进 Word,用「文本转换成表格」按制表符重建行列
- 重点核对数字、小数点、单位和符号,这些地方最容易认错
- 原扫描件偏模糊时,先用 300dpi 以上重新扫描再识别,准确率会明显提高

常见问题
pdf转word只有图片,怎么把文字找回来?
先按 Ctrl+F 搜表格里的字。搜得到就用复制加选择性粘贴的办法取文字,搜不到说明没有文字层,只能用 OCR 识别出来再人工校对。
PDF转Word后表格点不进单元格,是哪里设置错了?
多半是输出模式选了「以图片输出」或者整页转图,也可能是原文件本身就是扫描件。换「偏流式/可编辑文字」模式重转一次,再点单元格试。
pdf转word图片没办法删掉,应该怎么处理?
那张图就是转换结果本身,直接删掉文字也跟着没了。正确做法是用能输出文字的模式重转,或者在 Word 里对图片做「图片转文字」,拿到文字之后再把图删掉。
如何完整的把pdf转换为word而不变成一张图?
前提是 PDF 里有文字层。先确认 Ctrl+F 搜得到,再选「偏流式」或者「可编辑文字」模式转换;扫描件先做 OCR,再逐项核对数字。
扫描版PDF在Word里Ctrl+F搜不到字,还有办法编辑吗?
还有,只能走 OCR。把清晰扫描件转成文字,逐字校对后按制表符重建成表格,重点看数字和小数点。
推荐阅读
Word转PDF图片模糊,先分清是导出压缩还是转换DPI的问题
PDF转图片后清晰度不高怎么办,先判断源文件再统一参数批量导出
相关推荐
PDF删除文字内容怎么删除,搜得到就直接编辑,搜不到按图片处理
 如何完整的把pdf转换为wordpdf转word图片没办法删掉pdf表格转word可编辑软领PDF阅读转换器

 提示