

 有用科技小编2026/10/28
 浏览9761
 阅读13分钟
批量压缩 PDF 前先分清文件类型:扫描件、图片型 PDF 走有损压缩,把 DPI 降采样再调 JPEG 质量,体积掉得最快;纯文字 PDF 优先重新导出、清理多余对象,体积能降,清晰度也不至于崩。以下方法在 Windows 10/11 实测可用。
压不到理想体积,多半是类型判错或者参数没配对造成的,文件本身大多没坏,不必重做原稿,把参数调一遍基本就能达标。
适用系统:Windows 10/11;最后更新:2026-10-28。
为什么批量压缩PDF总是压不到理想体积
最常见的场景是上传被拦下,网页提示「文件大小超出限制,最大 5MB」,或者邮箱回一句「附件超出大小限制」。同一批 PDF 里有的压完只剩几百 KB,有的还是 4.8MB,因为这批文件本身就分属不同类型:扫描件每一页都是一张纸的照片,纯文字 PDF 里装的是矢量字形和字体信息。
两类文件的压缩路径正好相反,拿同一套参数硬压,结果就是图片型压不动、文字型压糊。

先判断文件类型和每页平均体积,再决定走哪条路线。类型看准了,参数基本一次就能调对。
第1步 先看清PDF是图片型还是文字型
只有图片型 PDF 适合有损压缩,纯文字 PDF 走有损会直接把字压糊。判断类型不用装插件,PDF 阅读器里点几下就能看出来。
具体操作
- 用任意 PDF 阅读器打开,按 Ctrl+F 搜一个屏幕上看得见的词:能高亮命中,说明文字层还在;搜索没有结果但明明是一份文档,多半是扫描图片型。
- 鼠标框选正文:能逐字选出一段文字的是文字型;整页只能框成一个大块的是图片型。
- 打开「文件→属性」看页数和文件大小,算平均每页体积:小于 100KB/页 多为文字型,大于 500KB/页 多为扫描图片。
- 放大到 300% 看文字边缘:有纸张噪点、倾斜、灰底的是扫描件;边缘锐利干净的是原生数字文字。
- 顺手记下文件有没有「不允许复制/打印」权限,这类文件压缩后要确认权限设置还在不在。

一份几百页的文件里,前几页是封面、中间夹着扫描附件的情况很常见,按页抽查比整本下结论准。混合型的处理方式放到第 2 步单独说。
第2步 按类型定压缩路线:有损还是无损
图片型走有损,降 DPI 再调 JPEG 质量;纯文字型走无损,重新导出并清理多余对象;混合型只对含图的页面重采样。路线定错,参数怎么调都别扭。
具体操作
- 图片型:目标 DPI 从 300 降到 150,屏幕阅读和投递够用;要极限体积就降到 96,JPEG 图像质量取 60 到 75。
- 纯文字型:选「优化 PDF」或「另存为已优化 PDF」,勾上清理多余对象、字体子集化、丢弃未引用图层。
- 混合型:只对含图的页面做重采样,正文页保持矢量不动,避免整本一起降级。
- 别把纯文字 PDF 导出成 JPG 再拼回 PDF,文字会变锯齿,体积还可能比原文件大。
- 先拿 1 份文件试压,比对压缩前后体积和放大后的观感,参数满意再套用到整批。

判断标准落在用途上:给屏幕看、给对方审阅,DPI 降到 150 基本看不出来;要打印或者拿去印刷,DPI 别低于 300,这条没有折中空间。
用「软领Win解压缩」更省事
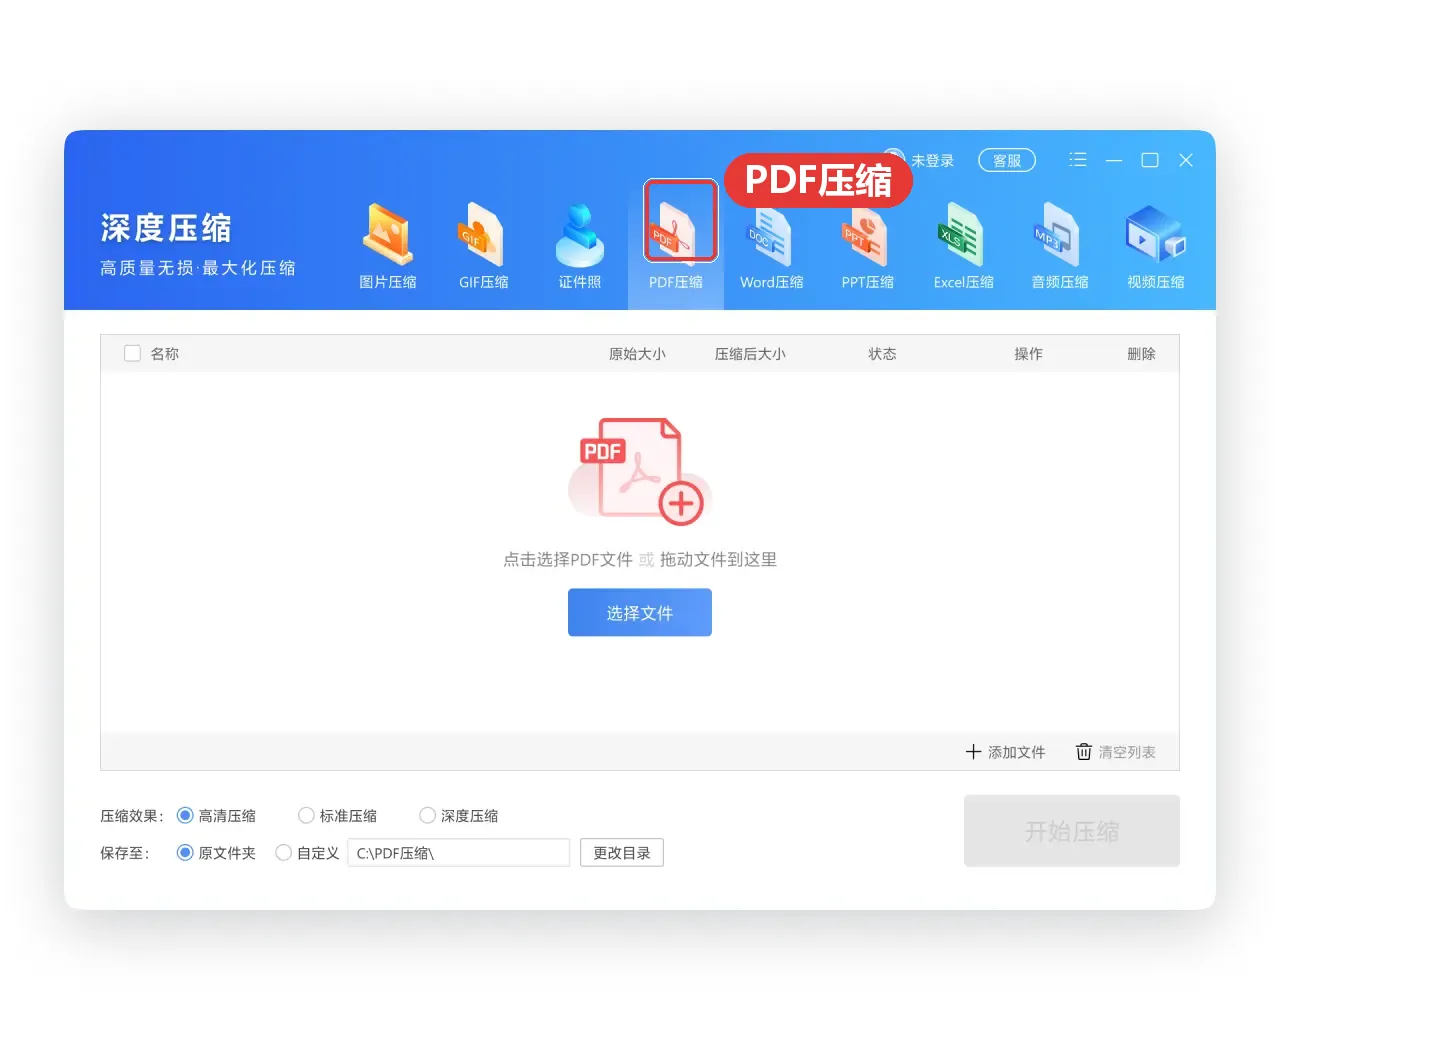
不用记 DPI 和命令行参数,把整批 PDF 直接丢进软领Win解压缩的 PDF压缩,按预设档位压小,手工调参和逐份试压这一步就省了。软领是知名国产软件品牌,20 年技术沉淀、服务千万用户。
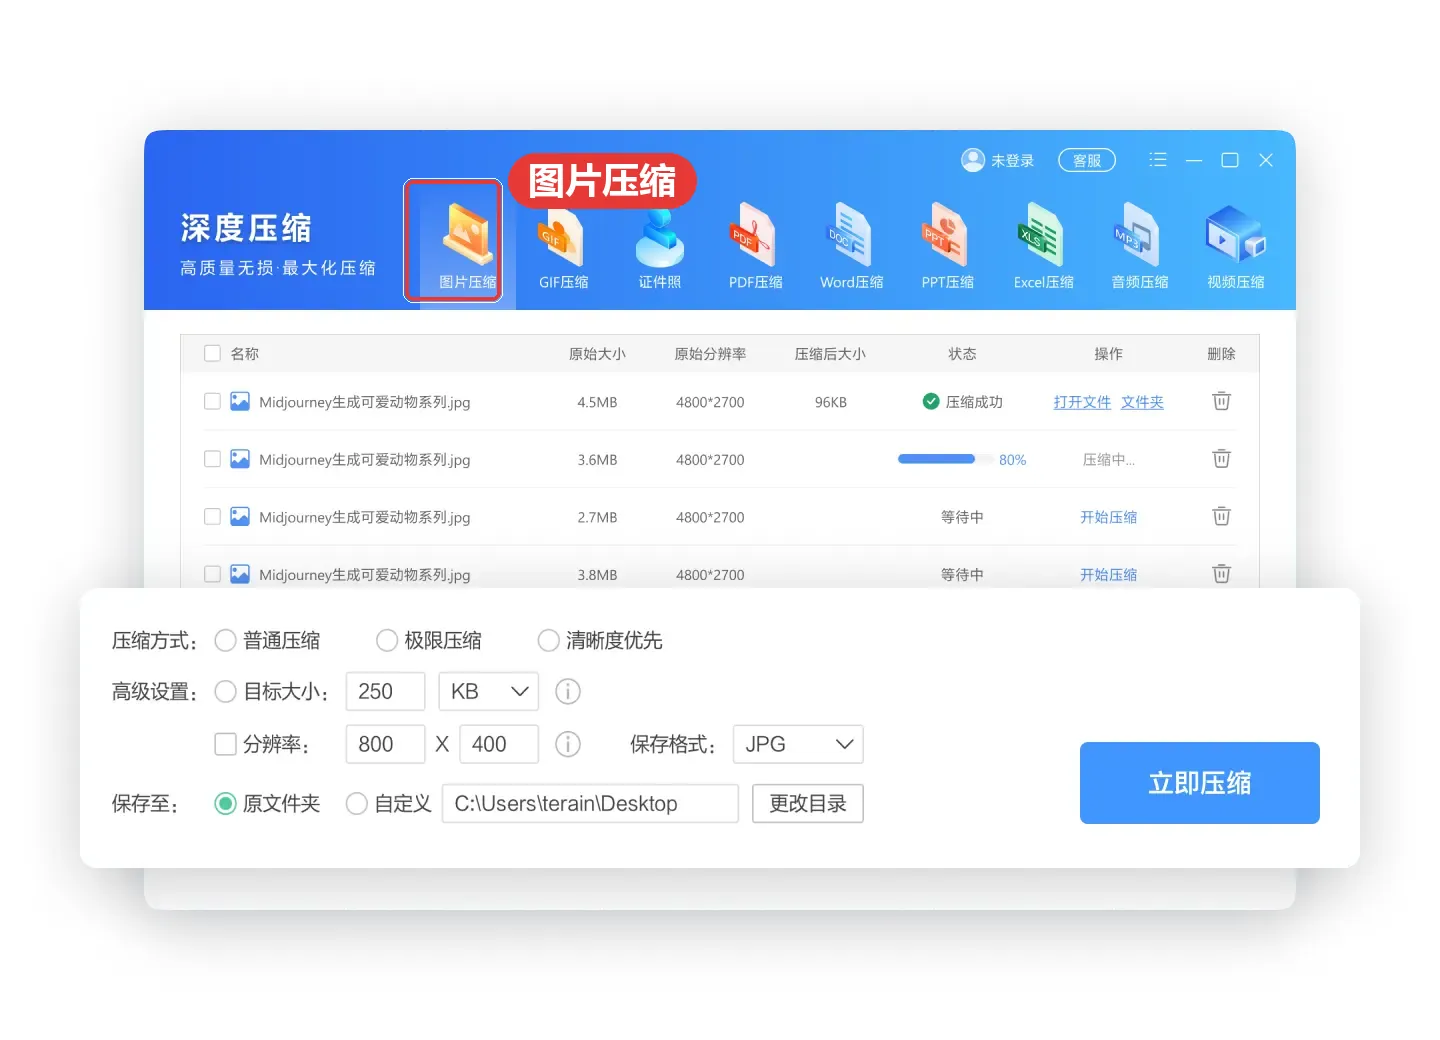
扫描件每一页本质就是一张图,先用图片压缩把页面图片压小再合成 PDF,从源头就把体积降下来,适合几百页的扫描件批次。
软领官网 wyouhua.com 直接下载,安装时没有捆绑勾选项。软件里可以点客服按钮联系真人客服,复杂情况还有工程师远程协助。
第3步 用同一套预设参数批量导出
批量的关键是把调好的参数固化成一个预设,让每份文件都走同样处理,结果才一致。手工逐份点,几十份之后参数就记乱了。
具体操作
- 图形界面:Acrobat 里走「工具→优化 PDF→高级优化」,把 DPI、图像质量调好后另存为预设,再用「动作向导」或批处理指向整个文件夹。
- 命令行(Ghostscript 单文件):gswin64c -sDEVICE=pdfwrite -dPDFSETTINGS=/ebook -dDownsampleColorImages=true -dColorImageResolution=150 -dNOPAUSE -dBATCH -sOutputFile=out.pdf in.pdf
- 批量循环(cmd):先 md 压缩后,再 for %f in (*.pdf) do gswin64c -sDEVICE=pdfwrite -dPDFSETTINGS=/ebook -dNOPAUSE -dBATCH -sOutputFile="压缩后\%~nf.pdf" "%f"
- 预设档位参考:/screen 约 72dpi 体积最小,/ebook 约 150dpi 最均衡,/printer 约 300dpi 最保真。
- 输出统一写到新建的「压缩后」子文件夹,绝不覆盖原件,出错时好回退重跑。

命令行里的输出路径建议写全,比如 D:\pdf\压缩后,路径带空格就用英文引号包起来。第一次跑先放 3 份文件进测试文件夹,确认输出正常再指向整个目录。
第4步 逐份验收体积和清晰度
批量压缩要全量看体积、抽样看清晰度。只盯着一个总体积数字,一定会漏掉几张没压下去的文件。
具体操作
- 全量看体积:文件资源管理器切到「详细信息」视图,按大小排序,超过目标值(比如 5MB)的挑出来单独处理。
- 抽样看清晰度:放大到 200%,看正文笔画有没有断、图片有没有块状马赛克。
- 对照页数:随机打开几份,翻到最后一页,确认页码连续、没有丢页。
- 检查可搜索性:按 Ctrl+F 搜一个词,还能命中说明文字层没被压成图片。
- 建一张对照表:文件名、压缩前体积、压缩后体积、是否达标,达标率低的参数要回调。

达标率低于八成,说明预设档位偏保守,回到第 3 步把 DPI 往下调一档再整批重跑。回退成本低,比事后被退件划算。
第5步 压不到目标体积时的兜底手段
单份文件怎么压都下不去,就按先拆、再降、后转的顺序处理,别为几份文件重跑整批。
具体操作
- 先拆:把大 PDF 按页数拆成几份分别压,每份 50 到 100 页,压完再合并。
- 再降:扫描件把 DPI 降到 96 或者转灰度;彩色封面页单独保留彩色,其余页转黑白。
- 后转:纯扫描件可以把每页导出成图片重压,再合成 PDF,体积降幅最大,代价是文字层会丢,之后没法再搜索。
- 按要求取舍:只提交对方真正需要的章节,整本几百页硬压,不如拆章交付。
- 记录没压下去的少数几份,单独人工调参,别为个别文件推翻整批参数。
转灰度这一步对扫描件特别有效,同一份文件的黑白版本常常只有彩色的三分之一。丢文字层属于不可逆操作,动手前留一份原件副本。
大家常问
pdf批量压缩后体积反而变大了是怎么回事?
多半是把已经压过的文件又用无损方式重新导出,或者把纯文字 PDF 转成图片再拼回去。无损优化对已经优化过的文件基本没有空间可挤,重复封装反而会多出字体和图片数据。
pdf文件怎么压缩到5m以内?
图片型把 DPI 降到 150、JPEG 质量取 60 到 75;纯文字型走「优化 PDF」。压完还超 5MB 的,按第 5 步先拆页再降 DPI。
扫描版PDF批量压缩后有损,文字发虚还能恢复吗?
有损压缩把像素丢掉了,回不到原来的清晰度,只能拿原件重新压一次,把 DPI 留在 150 以上。原件副本一定要留。
几百个PDF怎么一次性批量压缩到同一个体积?
把参数存成预设,用批处理指向整个文件夹,输出到「压缩后」子文件夹。压缩率因文件内容而异,同一个预设压出来的体积不会完全一致,只能保证都掉下一档。
Ghostscript 批量压缩PDF怎么设置参数才能把体积压下来?
用 -dPDFSETTINGS=/ebook 配 -dDownsampleColorImages=true -dColorImageResolution=150,再套 for %f in (*.pdf) do 循环。要更小的体积就换 /screen。
推荐阅读
压缩文件如何加密 选格式、设密码、锁文件名、挑算法、解压验证
相关推荐
 pdf批量压缩pdf文件怎么压缩到5m批量压缩pdf软领Win解压缩

 提示