



 有用科技小编2026/11/16
 浏览9780
 阅读7分钟
「软领PDF阅读转换器」的OCR文字识别能把乱码的页面重新变成可以选中的正常文字:打开文件后点提示条上的「图片OCR」,在「提取文字」窗口点「开始提取」,识别完点「复制全部」就能用。实测一份3页的合同扫描件走「转换」→「扫描件转换」转成 Word 后,得到979字可编辑文字,没有嵌整页图片。
用「软领PDF阅读转换器」把乱码页面的文字重新提取出来
这个功能处理的是页面上选不中字、复制出来是乱码的文件,软件对着这一页做一遍OCR文字识别,把读出来的内容写进「提取结果」里。它不要求页面上的字能选中,扫描件和图片型 PDF 都走这条路。
第1步 打开扫描件,跳到需要文字的那一页
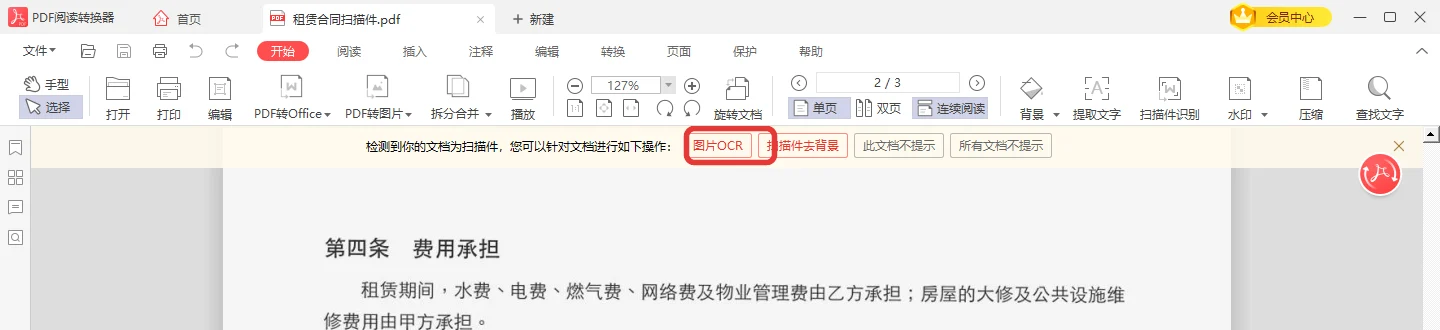
用「软领PDF阅读转换器」打开这份文件,顶部会自动提示「检测到你的文档为扫描件,您可以针对文档进行如下操作」。文件打开后,先把窗口底部的页码框调到需要文字的那一页,再进入下一步。
第2步 点提示条上的「图片OCR」
提示条上的「图片OCR」就是识别入口,点一下会打开「提取文字」窗口。后面的识别和复制都在这个窗口里完成。
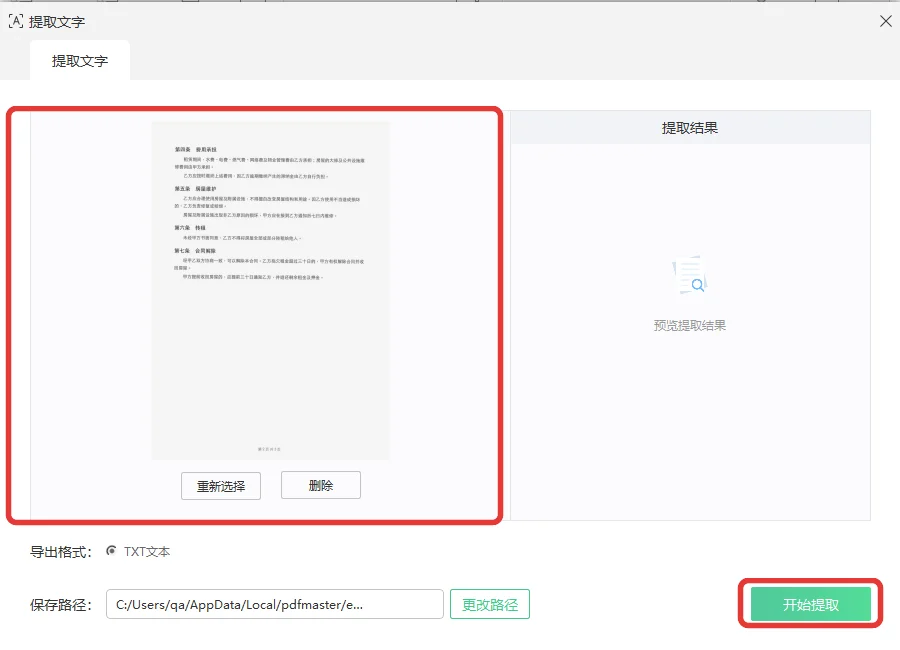
第3步 在「提取文字」窗口点「开始提取」
窗口打开后,左边是这一页的预览,右边是「提取结果」。这一步先看一眼预览里是不是要找的那一页,确认无误后点「开始提取」,软件就开始读页面上的文字。
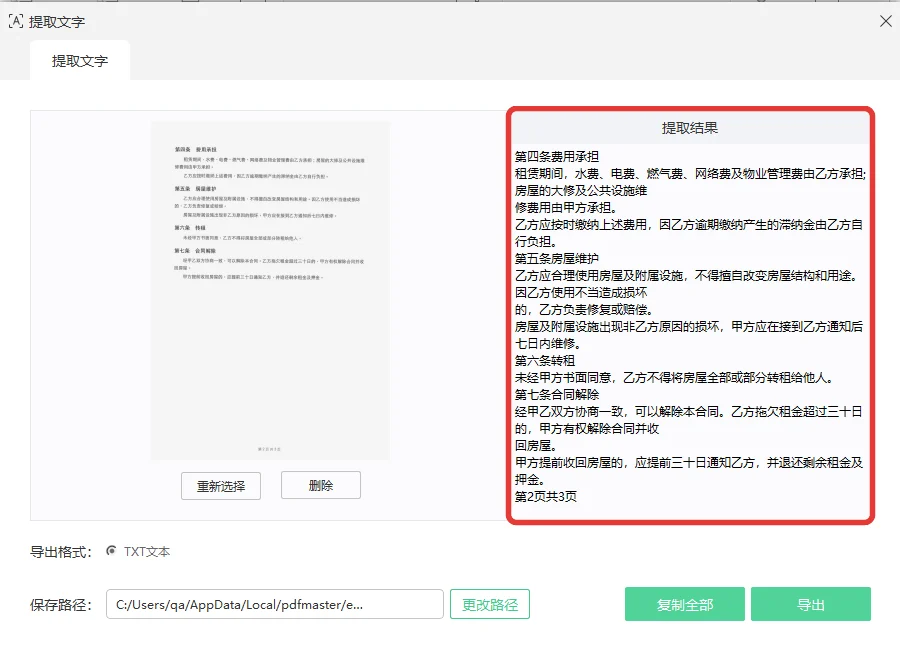
第4步 点「复制全部」把文字取走
识别结束后,原来的按钮会变成「复制全部」和「导出」。点「复制全部」,这一页的文字就进了剪贴板,粘到聊天窗口或者文档里都能用;实测合同扫描件第2页的条款识别出来是完整、正常的中文。
不同情况该走哪个入口
同样是乱码,文件的类型不一样、要处理的范围不一样,在软件里点的位置也不一样。手头的文件属于下面哪一种,照着对应的入口走就行。
| 遇到的情况 | 在软件里怎么做 | 入口在哪 |
|---|---|---|
| 只有一个页面要变回正常文字 | 点「图片OCR」,把这一页重新识别一遍 | 打开文件时顶部的提示条 |
| 整份多页扫描件都要变成文字 | 在转Word页勾上「精准转换模式」再转换 | 「转换」→「扫描件转换」,「开始」→「扫描件识别」是同一个入口 |
| 手头要识别的是图片 | 点「重新选择」,换成一张 png 或者 jpg 图片 | 「提取文字」窗口左边的预览下面 |
| 识别结果要留档 | 导出格式是 TXT文本,点「导出」保存,位置不合适可以点「更改路径」 | 「提取文字」窗口 |
复制乱码时要注意什么
PDF乱码怎么解决,要看乱码出在哪一类文件上,也要看这份文件要处理的范围有多大。动手之前先把下面几点过一遍,后面能少走弯路。
先分清扫描件和字体特殊的 PDF
复制出来是乱码,常见于扫描件和字体特殊的 PDF,图片型 PDF 同样如此。整页的字都选不中的那种,基本可以按扫描件来处理,交给OCR文字识别重新读一遍。
提示条不再弹出时从哪里进
提示条上有「此文档不提示」和「所有文档不提示」,点过以后这份文件就不会再自动提示。需要识别的时候,从「图片转换」→「OCR文字识别」进去,或者在「开始」里点「提取文字」,识别窗口照样打开。
一次只识别当前这一页
「提取文字」窗口每次只识别底部页码框里的当前页。要提取第3页的文字,就先回到底部页码框跳到第3页,再点一次「开始提取」,第3页的结果才会出来。
为什么用「软领PDF阅读转换器」
装的时候不用提心吊胆。软领是知名国产软件品牌,20年技术沉淀,服务千万用户,安装包从官网 wyouhua.com 直接下载,无毒绿色,不带捆绑软件、插件和全家桶。
用的时候也清静。软领不靠广告挣钱,所以软件不会拿弹窗和推荐打扰你,打开就能安心处理手上的文件。
用得越久越顺手。软件持续维护更新,越用越好用,以后处理别的 PDF 文件,走的还是熟悉的这套界面和入口。
真遇上卡住的地方也有办法。如今到处都是 AI 客服,想找到一个真人很难;软领旗下所有产品的界面上都有客服按钮,点一下就能联系到真人客服帮你解决电脑问题,复杂情况还有专业工程师远程协助。
大家常问
扫描件PDF复制出来是乱码,怎么解决?
扫描件属于图片型 PDF,页面上的字选不中,复制出来就是乱码。用「软领PDF阅读转换器」的OCR文字识别把页面重新读一遍,拿到的是正常中文,可以直接复制使用。
PDF复制出来的文字是乱码,但字能选中,也是扫描件吗?
不完全是。复制结果乱码也常见于字体特殊的 PDF。整页的字都选不中、点不动的,才基本可以按扫描件或者图片型 PDF 处理。
整份几十页的扫描件也要一页一页提取吗?
不用。走「转换」→「扫描件转换」,在转Word页勾上「精准转换模式」,整份文件一次转成可编辑文字的 Word。
OCR文字识别要开通会员吗?
OCR文字识别属于会员功能,开通会员后可用,会员权益里还有「无限次OCR扫描」这一项。
 pdf复制出来是乱码pdf复制文字乱码怎么办pdf乱码怎么解决软领PDF阅读转换器





 提示