


 有用科技小编2026/09/07
 浏览9846
 阅读12分钟
PDF搜索文字搜不到时,先拖选正文判断文档是文字型还是扫描件:扫描件要先做OCR生成可搜索文字层;文字型则把搜索里勾的“区分大小写/全字匹配”去掉再搜。仍不行就跑 sfc /scannow 修复系统文本组件,最后另存一份副本排除PDF内部损坏。以下方法在 Windows 10/11 实测可用。
多数PDF文字显示正常却搜不到,是文件本身没有文字层或搜索条件收得太紧造成的,不是文件坏了。按上面顺序排查,不少情况几分钟就能解决,不用重装阅读器,也不用急着找恢复工具。
适用系统:Windows 10/11;最后更新:2026-09-07。
为什么PDF里明明有字却搜不到
在PDF正文里按 Ctrl+F 输入一个肉眼可见的词,阅读器却提示“找不到匹配项”。这种“看得见、搜不到”通常有三类原因:文件是扫描图片、搜索选项限制太严、PDF内部结构损坏。

先花十几秒确认文字能否选中,再按这三个方向处理,能省去大量反复重装和乱点操作。
方法1 先判断PDF是文字型还是扫描件
这一步决定后面的修法:能选中单个字的是文字型PDF,只能拖出一整块蓝色矩形的是扫描图片。
鼠标左键在正文上拖选。按下某个字或词组,说明文档带文字层;拖动后只出现整块蓝色矩形,说明这一页实际是图片,文字是印在图片里的。阅读器若停在抓手状态,先切回“选择工具”再拖。
判断结果直接决定修法:文字型PDF搜不到,重点查搜索选项和文件完整性;扫描件搜不到,必须先补一道OCR文字层。
操作步骤
- 鼠标左键在正文上拖选:能选中单个字或词组,就是文字型PDF;只能拖出整块蓝色矩形,就是扫描图片
- 阅读器若停在抓手或手型工具状态,先切回“选择工具”再拖选
- 右键查看文件属性,若“Producer/创建程序”或“页面大小”等元数据缺失,更偏向扫描件或旧转换工具生成的文件
方法2 关闭“区分大小写/全字匹配”再搜索
很多阅读器默认把搜索词当精确整词处理,关键词里字母多、大小写不一致时就容易漏报。取消这两个勾选项,通常立刻能搜到。
按 Ctrl+F 打开搜索框,点右侧齿轮或选项图标,把“区分大小写”和“全字匹配”两个勾都去掉。搜索范围要选“当前文档”,不要选“注释”“书签”或“表单域”。

重新敲一次关键词,把长句换成两个字的短词再试,命中率会明显提高。
操作步骤
- 在PDF内按 Ctrl+F 打开搜索框,点击右侧齿轮或选项图标
- 取消勾选“区分大小写”“全字匹配”,不确定时只保留“包含关键词”
- 把搜索范围设为“当前文档”,不是“注释”“书签”或“表单域”
- 重新输入关键词测试;长句搜不到时,换成两个字的词分段搜
用「软领PDF阅读转换器」更省事
想确认一份PDF到底有没有可搜索文字层,最直接的办法是换一个能完整加载文字层的阅读器再搜一遍。软领PDF阅读转换器不依赖网页预览框,打开文件后在本地处理,结果更接近PDF本身的状态。
用它的“PDF阅读”功能打开同一份PDF,按 Ctrl+F 输入关键词,结果会完整落在文档里,方便直接跳页、复制上下文。网页预览框经常出现“搜不到就提示无结果”的假象,是因为它没有加载完整文档;换成完整打开文字层的阅读器,多数PDF立刻能搜到。
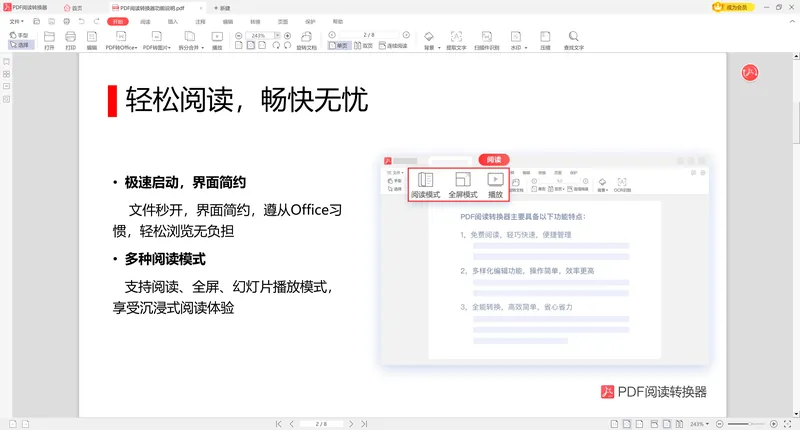
仍搜不到时,用“PDF转Word”功能把同一份文件转成Word,再用Word搜同一个词。Word能搜到,说明原PDF有可搜索文字层,问题出在之前用的阅读器;Word也搜不到,则说明文字层确实缺失或内容是扫描图片,后面直接做OCR更高效。
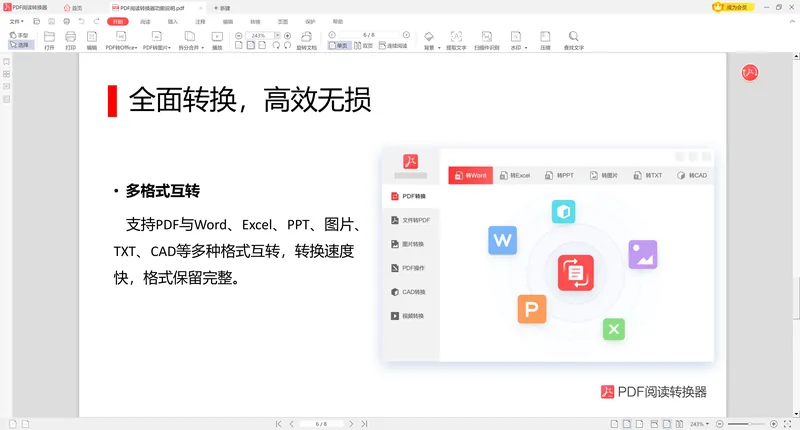
软领是知名国产软件品牌,下载入口在官网 wyouhua.com,安装过程没有捆绑勾选。真遇到拿不准的复杂情况,软件里可以点客服按钮联系真人,必要时请工程师远程协助看具体文件。
方法3 扫描件先用OCR识别成可搜索文字
扫描件在PDF里是一张图片,文字没有文字层,任何阅读器直接按 Ctrl+F 都搜不到。先做OCR,把这些图片里的字识别成可搜索文字层,再搜才有结果。
打开扫描件,在阅读器里找“OCR文本识别/识别文字”菜单,识别范围选“整篇文档”,语言选对中文或英文。识别完成后别直接覆盖原文件,先点“另存为”保存一份新PDF,再用 Ctrl+F 验证。

OCR生成的是可搜索文字层,不是把原图变成纯文本,所以验证时仍用PDF阅读器打开,不要双击后当成记事本查看。
操作步骤
- 用带OCR文字识别功能的PDF阅读器打开扫描件,找“OCR文本识别/识别文字”菜单
- 识别范围选“整篇文档”,语言选对中文或英文,开始识别
- 识别完成点“文件→另存为”,保存一份新的可搜索PDF,避免覆盖原扫描件
- 用阅读器打开新副本,按 Ctrl+F 搜索肉眼可见的词验证
方法4 运行系统文件检查修复搜索组件
PDF搜索依赖Windows的文本与索引组件。组件损坏时,多份PDF可能同时出现“明明有字却搜不到”,系统其他地方的搜索也不正常。跑一次系统扫描能把这些组件修复回来。
以管理员身份打开命令提示符,输入 sfc /scannow 并等它跑完。若提示“Windows资源保护无法修复部分文件”,再跑 DISM 修复系统映像,完成后重启验证。
操作步骤
- 按 Win+R 输入 cmd,按 Ctrl+Shift+Enter 以管理员身份打开命令提示符
- 输入 sfc /scannow 并回车,等进度到100%;提示“Windows资源保护无法修复”则继续下一步
- 输入 DISM /Online /Cleanup-Image /RestoreHealth 回车,联网等待完成
- 重启电脑,重新打开同一个PDF按 Ctrl+F 测试
方法5 另存为副本排除PDF内部损坏
PDF内部索引或字体映射写错时,正文显示正常,搜索索引却对不上。另存为新文件会重建这部分结构,不少这种情况能恢复搜索。
在阅读器里点“文件→另存为”,格式仍选PDF,文件名加个 _repair 再保存。若阅读器有“优化”或“减小文件大小”,可再另存一次,触发完整重建。
操作步骤
- 打开有问题的PDF,点“文件→另存为”,格式仍选PDF,文件名加 _repair 后保存
- 若阅读器有“优化/减小文件大小”,再另存一次触发完整重建
- 关闭原文件,打开新副本用 Ctrl+F 搜索同一个关键词
- 新副本仍然搜不到,回到方法3做OCR识别,或换一个阅读器交叉验证
常见问题
PDF文件里明明有这些字,为什么按 Ctrl+F 就是搜索不到?
先看文字能不能选中。能选中单个字,问题多半在搜索选项或文件结构;只能选中整块矩形,说明这页是扫描图片,要先做OCR。
扫描版PDF能变成可搜索文字吗?
能。用带OCR功能的阅读器把图片里的字识别一遍,生成新的文字层后另存为新PDF,就能正常搜索和复制。
PDF搜索不到和字体没有嵌入有关系吗?
有可能。字体没嵌入或缺少Unicode映射时,文字能显示,复制出来却可能是乱码,搜索也未必命中。先另存为副本再搜,不行就转Word验证;仍乱码时只能靠OCR重新生成文字层。
同一份PDF在浏览器里搜不到,下载后用阅读器也搜不到,是文件坏了吗?
不一定。先拖选文字判断文件类型;文字型仍搜不到,按方法4和方法5检查系统组件和文件结构。真正的损坏通常阅读器会直接提示“文件已损坏”或“无法打开”,不会只是搜索没有结果。
PDF另存为副本后还是搜不到,还能怎么处理?
换一个阅读器再搜一次,确认不是单一软件的问题。仍然搜不到,基本可以判定文字层缺失或编码异常,直接做OCR把整个文档重新生成一遍文字层,比继续找原文件里的文字更快。
推荐阅读
PDF怎么直接编辑修改内容文字 文字层可直接改,扫描件先OCR
PDF添加文字不显示怎么办?从字体、文本框到保存方式依次排查
PDF转图片JPG格式发黑怎么解决?背景色、分辨率和扫描件一起调
相关推荐
PDF打印受限咋办?知道密码就改安全设置,没密码就用解密功能
 pdf无法搜索文字pdf不能搜索文字怎么解决pdf搜索功能失效软领PDF阅读转换器



 提示