


 有用科技小编2026/09/16
 浏览9767
 阅读10分钟
PDF复制出来的文字变成问号、方块□□□或者怪符,通常有两种底子:能拖选文字的是文本型PDF,编码还有办法修;完全选不中的是扫描图,页面里没有文字层,得先做 OCR 识别。多数情况按「换阅读器对比 → 查字体是否嵌入 → 转成Word重新生成编码」这个顺序走一遍,都能复制到正常文字。
这类问题多数是字体没嵌入或阅读器字体映射对不上造成的,原文件大多没坏,不必急着重做。以下方法在 Windows 10/11 实测可用。
适用系统:Windows 10/11;最后更新:2026-09-16。
先搞清楚:是编码坏了,还是根本没有文字层
在 Acrobat 里选中一段PDF文字按 Ctrl+C,粘到记事本里变成一排问号、方块□□□,有时还是“å¤æ–‡”这类怪符,这就是复制乱码。页面显示正常、复制出来对不上,问题一般出在文字层编码、字体嵌入、页面是否带文字层这几个环节。前两个环节能在本机处理,页面没有文字层的扫描图只能先做 OCR。

先判断手上的PDF属于哪一类,再决定是改设置还是重新生成文字,比反复换软件、反复重装省事得多。
方法1 先确认PDF里的文字能不能被选中
能拖选文字,说明页面里有文字层,编码问题还有办法修;怎么拖都选不中,基本可以判定是扫描图,本机改设置没用。
操作步骤
- 用阅读器打开PDF,按住鼠标左键从一段文字上拖过去,看是否出现蓝色选中高亮
- 能选中就按 Ctrl+C,粘到记事本里(Win+R 输入 notepad 回车),看是正常文字还是问号、方块
- 完全选不中,光标变成手型或十字,说明这是扫描图,页面里没有文字层
- 扫描图先做 OCR 文字识别,把识别结果复制出来,再回到排版环节
判断的关键在光标形态:文本型PDF里鼠标经过文字会变成 I 形光标,扫描图整页都是手型,怎么点都选不亮。这一步花十几秒,却能决定后面要不要继续往下做。

确认是扫描图的话,识别效果跟清晰度直接相关,300dpi 以上的扫描件识别出来的错字明显更少。
方法2 换一个阅读器复制同一段文字对比
只有一个阅读器复制出来是乱码,问题就在它的字体映射,换一个能正常复制的就行;几个阅读器都乱,才说明文件本身有毛病。
操作步骤
- 同一个PDF分别用 Acrobat、Edge 浏览器、WPS 各打开一次
- 每次选中同一段文字,Ctrl+C 粘到记事本,逐个对比结果
- 只有一个阅读器出乱码:直接用能正常复制的那一个,事情到此为止
- 几个阅读器都乱:跳过换软件这条路,继续做方法3
Edge 浏览器用的是内置 PDF 引擎,字体替换策略和 Acrobat 不一样,所以同一个文件在两处结果不同很常见。对比时用同一段文字、同一个记事本,结果才有可比性。

如果几个阅读器复制都正常,之前那次乱码多半出在粘贴的目标软件上,先粘进记事本做一次纯文本中转就能避开。
用「软领PDF阅读转换器」更省事
软领PDF阅读转换器能直接打开PDF、拖选文字并复制,走的是自己一套文字解析方式,绕开不同阅读器之间的字体映射差异,不用来回装软件试。
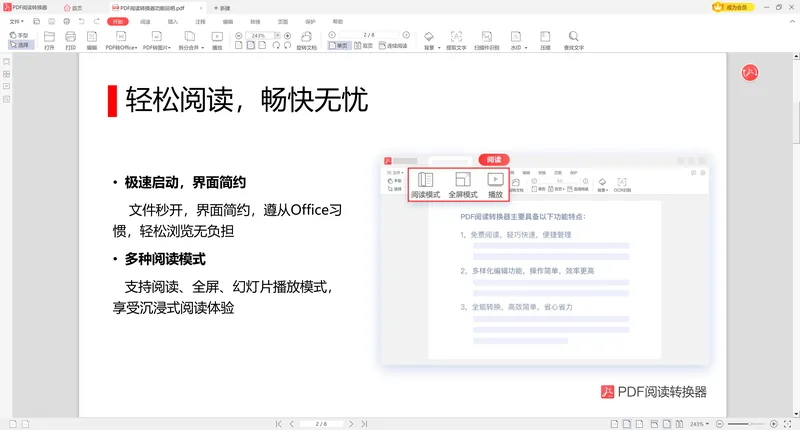
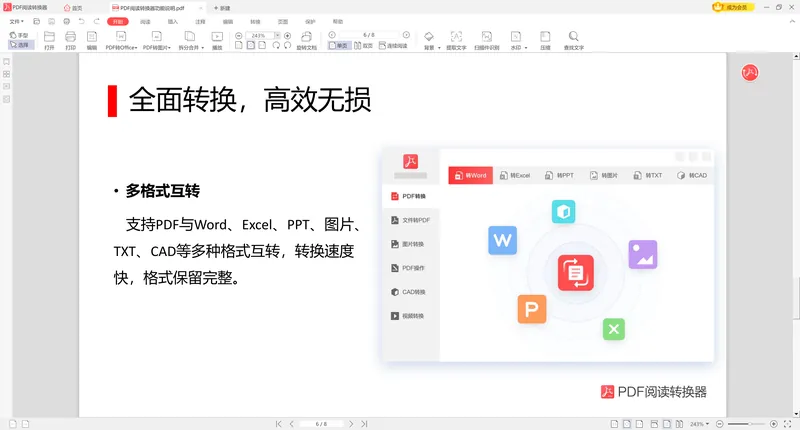
碰到字体没嵌入、编码本身就乱的PDF,可以用它的PDF转Word,把文件导出成 .docx,文字编码在转换过程中被重新生成一遍,再复制出来就不是问号方块了。
软领是知名国产软件品牌,20 年技术沉淀、服务千万用户。软领官网 wyouhua.com 直接下载,安装无捆绑勾选项;软件里有客服按钮,可以联系真人客服,复杂情况还有工程师远程协助。
方法3 检查PDF的字体是不是没嵌入
文档属性里字体标着「未嵌入」的PDF,换台电脑复制就会乱,这是源文件生成时就留下的缺陷,本机设置改不回来。
操作步骤
- 在 Acrobat 里按 Ctrl+D 打开「文档属性」,切到「字体」标签页
- 逐行看字体名,留意后面是否标着「未嵌入」
- 记下未嵌入的字体名,判断是不是生僻字体或自定义编码字体
- 确认是源文件缺陷后,不要再折腾本机字体设置,直接走方法4
判断依据很直接:列表里标着「未嵌入」的字体,接收方电脑只有装了同名同版本字体才显示正常,没装就只能靠系统替换,替换出来的字符映射一旦对不上,复制出来就是怪符。这类PDF在 Acrobat 里点复制时,还可能弹出「无法提取嵌入字体」的提示。

想核对字体名字,可以打开 C:\Windows\Fonts 看看本机装没装同名字体,装了也未必版本一致,所以换机器仍可能乱。
方法4 把PDF转成Word后重新复制文字
转换的过程会把文字编码重新生成一遍,转成 Word 之后再复制,多数文件就不乱了。
操作步骤
- 用转换工具打开PDF,选择「PDF转Word」,导出成 .docx 文档
- 在 Word 里选中文字复制,先粘到记事本里去掉隐藏格式
- 再从记事本粘进目标文档,避免带来源文件的字体样式
- 如果转换后仍是乱码,回到方法1确认是不是扫描图,改走 OCR 识别
先过一遍记事本这一步很关键。Word 里直接复制会带上原文件的字体名和编码信息,粘到别的软件里可能再次触发替换,变成方块。记事本只留纯文本,等于把编码洗了一遍。

转换后如果只有个别字变成方框,多半是原文用的字体本机没装,把缺失字体放进 C:\Windows\Fonts 后重新打开 Word 就能正常显示。
常见问题
PDF复制文字粘到Word里变成问号怎么办?
先把文字粘到记事本(Win+R 输入 notepad 回车)里看一眼。记事本正常、Word 里变问号,说明是 Word 的字体替换问题,在 Word 里全选文字改成宋体或微软雅黑即可;记事本里就是问号,按方法3查字体有没有嵌入。
为什么同一个PDF在Edge里复制正常,在Acrobat里是乱码?
两个软件的字体替换策略不同。Acrobat 严格按嵌入字体和编码表取字符,缺字就乱;Edge 用的是内置引擎,会先做一次字体回退。遇到这种情况,直接用能正常复制的那一个就行。
PDF文字选中后粘出来全是方块□□□怎么解决?
方块说明字符编码取不出来,常见原因是字体没嵌入或用了自定义编码字体。先按 Ctrl+D 看文档属性里的字体列表,有明显标着「未嵌入」的,就用方法4转成 Word 重新生成编码。
扫描版PDF复制不了文字,只能靠OCR识别吗?
是。扫描图整页都是像素,没有文字层,任何阅读器都选不中。用带 OCR 的工具识别一遍,300dpi 以上的扫描件识别准确率更高,识别完的文字要人工核一遍数字和标点。
文档属性里显示字体「未嵌入」,怎么让PDF重新生成文字编码?
本机改不了源文件,得重新走一次生成流程:把PDF转成 Word 或纯文本,让工具重新排版并写入新编码,再导出成新的PDF。这一步用软领PDF阅读转换器的「PDF转Word」就能做。
推荐阅读
相关推荐
 pdf文字复制出来是乱码pdf复制是问号方块pdf字体没嵌入怎么办软领PDF阅读转换器



 提示