


 有用科技小编2026/09/27
 浏览9807
 阅读11分钟
PDF转Word后一行一个回车,多半是转换时按行输出留下的硬回车(¶)。先按 Ctrl+Shift+8 显示编辑标记,分清 ¶ 和软换行 ↓,只处理 ¶;段落少就直接 Ctrl+H 把 ^p 换成空格,段落多先用占位符把真段落藏起来,再用通配符只删句末那个回车。以下方法在 Windows 10/11 实测可用。
这类问题多数出在转换环节的输出方式上,原文件本身没坏,也不用重新排版整篇,按顺序处理一遍就能把段落接回去。
适用系统:Windows 10/11;最后更新:2026-09-27。
PDF转Word后一行一个回车,到底是怎么回事
从 PDF 转出来的 .docx 一打开,每行末尾都挂着一个 ¶,一整段文字被切成十几行,改一个字整段跟着重排。Word 2016、2019、Word 365 里表现都差不多,Windows 10 1803 之后的版本也一样。
根源在转换那一步:多数转换工具按「行」输出文本,PDF 里每一行的位置被当成一个独立文本块,行尾统一补上硬回车(¶),原来的段落边界在转换时就没有保留下来。也有一种情况是 PDF 里本来就存在行内换行(软换行 ↓),那种标记删掉反而会把不该并的内容并到一起。

先看清是哪种标记惹的祸,再决定用全局替换还是保护式替换,能省掉反复重排的时间。
方法1 显示编辑标记,分清硬回车和软换行
先把该删的标记认出来再动手,删错了只会更乱。段末的 ¶ 是硬回车,是这次要清理的目标;行内的 ↓ 是软换行,属于排版换行,别动它。
顺手记下两个附加情况:行末多余的空格,还有连续空段落(¶¶),这两样在后面替换时一起清掉。
操作步骤
- Word 里按 Ctrl+Shift+8(Mac 是 ⌘+8)显示编辑标记,也可以走 开始→段落→显示/隐藏编辑标记 
- 段末的 ¶ 是硬回车,行内的 ↓ 是软换行,只有 ¶ 需要用查找替换处理,↓ 留着
- 记下两个情况:行末多余空格、连续空段落(¶¶),后面替换时一起清
- 动手前把文档另存一份,或者在原文件名后加「_bak」,改坏了还能退回来

标记显示出来之后,剩下的就是按行尾那一个符号做替换,不用再靠肉眼一行行找。
方法2 用查找替换把 ^p 换成空格,快速合回段落
文档只有几页、真段落又少的时候,一次全局替换最快。^p 在普通查找模式下代表段落标记,替换成一个半角空格,原来被切断的行就接回去了。
要注意 ^p 会连真段落一起并掉,段落多的文档先 Ctrl+A 复制一份,或者只选中出问题的那几段再替换。
操作步骤
- Ctrl+H 打开「查找和替换」窗口,点「更多」确认「使用通配符」没有被勾上,普通模式下 ^p 才有效
- 查找内容填 ^p,「替换为」填一个半角空格,点「全部替换」
- 这一步会把真段落也一起并掉,段落多的文档先 Ctrl+A 复制一份备份,或只选中出问题的区域再替换
- 合并得不干净的地方手动补回车,别在同一个文档里反复做全局替换
替换完把光标拉到文档开头,用 Ctrl+Home 回到第一行通读一遍,看有没有该分段的地方被连成一长串。
方法3 先保护真段落,再删多余回车
用占位符把原有的分段藏起来,删完行尾回车再还原,原文结构不会被吃掉。这一步顺序不能反,先保护再删,不是先删再补。
操作步骤
- 保护真段落:Ctrl+H,查找内容 ^p^p,「替换为」填 ###(占位符,避免用正文里已经出现的字符组合),点「全部替换」
- 删多余回车:查找内容 ^p,「替换为」填一个半角空格,点「全部替换」
- 还原分段:查找内容 ###,「替换为」填 ^p,点「全部替换」,原来的段落结构回来
- 全程确认「使用通配符」没勾;占位符和正文撞车就换成 #### 或者 【LF】 这类不容易出现的组合

做完这三步,段落和行数都应该回到接近原稿的样子,剩下的零星问题再手工处理。
用「软领PDF阅读转换器」更省事
转换时就按段落输出,从源头少产生一行一个的硬回车。软领PDF阅读转换器的 PDF转Word 在识别时保留原 PDF 的段落边界,同一段文字不会因为排版换行就被拆成十几个独立文本块,拿到手的 .docx 段落是完整的,编辑时改一个字也不会整篇重排。转完之后再按上面的方法清一遍残留标记和行末空格,两步下来比反复做替换省时间。
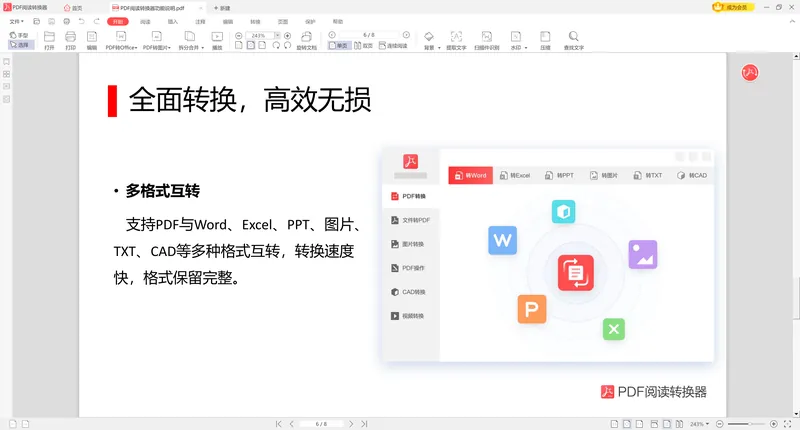
软领是知名国产软件品牌,20 年技术沉淀、服务千万用户;软领官网 wyouhua.com 直接下载,安装无捆绑勾选项。转换后段落仍有零星硬回车的文档,可以点界面上的客服按钮联系真人客服,复杂情况有工程师远程协助。
方法4 用通配符只删句末回车,保留有意义的分段
页数多、分段又有意义的时候,只删句末标点后面那个回车,其余不动。这样标题行、列表项前面的分段都能保住,正文里被行切断的句子又能连回整段。
操作步骤
- Ctrl+H 打开「查找和替换」,点「更多」→ 勾选「使用通配符」
- 查找内容填 ([!。!?;:])^p,「替换为」填 \1,只删句末标点之后的硬回车,段落标题、列表项的回车保留
- 勾上通配符后 ^p 有时不被识别,改用 ^13(段落标记的字符码);连续空段落可以用 ^13{2,} 替换成 ^13
- 替换前先存盘,替换后从头到尾拉一遍,重点抽查被合并的段落有没有缺字
这一招的前提是原 PDF 的标点用得规范。中文句号、问号、感叹号齐全的文档最好用,标点缺失或者中英文混排的文档,删完记得再核一遍。
常见问题
PDF转Word后一行一个回车,怎么一次性合并成一整段?
只是几页文档的话,Ctrl+Shift+8 确认行尾都是 ¶,再用 Ctrl+H 把 ^p 换成半角空格,点「全部替换」就能一次接回整段。
Word查找替换把 ^p 换成空格,真段落也被并掉了怎么办?
用方法3的占位符思路重做一遍:先把 ^p^p 换成 ###,再删单个 ^p,最后把 ### 还原成 ^p。已经并掉又没备份的,用 Ctrl+Z 撤销,撤销不回来只能按原 PDF 重排。
通配符 ([!。!?;:])^p 替换为 \1 为什么没生效?
勾了「使用通配符」之后 ^p 在部分 Word 版本里不认,把两处 ^p 都换成 ^13 再试。「替换为」里要写反斜杠加数字 \1,写成 $1 或者 & 都不对。
PDF转Word后行末还多出空格和空段落,怎么批量清掉?
先 Ctrl+H 查找 ^p^p 替换成 ^p 压掉空段落,再勾通配符用 空格{2,} 替换成一个空格清掉连续空格。清完再设一遍正文样式,首行缩进和行距会统一些。
扫描件PDF转Word后每行都是回车,还能自动合并吗?
扫描件要先做 OCR 再转,OCR 按图像文字行识别,输出天然一行一个回车。转出来之后可以按方法4的通配符批量清,但表格和分栏内容要人工核对,别整个文档一把替换。
方法5 回转换环节换输出模式,从源头少产生硬回车
前面几步都是补救,换掉「按行/文本框」输出模式重转一次才是治本。同一份 PDF 用保留段落的模式重转,拿到的 .docx 段落边界本来就是对的,后面的替换只用来收尾。
操作步骤
- 回到转换那一步,把输出模式从「按行/文本框」改成「保留段落/流式」,重转一次源 PDF
- 原转换工具没有这个选项,就换一个带该选项的工具重转,拿到段落结构正常的 .docx
- 重转后再按方法1到方法4清一遍残留硬回车和行末空格,然后统一设正文样式(首行缩进、行距)
- 纯图片、扫描件的 PDF 要先做 OCR 再转,直接转换必然是一行一个回车

换模式重转一次的代价,通常比在 Word 里改几百处回车小得多。手里还有原始 PDF 的话,这条路优先走。
 pdf怎么转换成word文档方法pdf转word后一行一行怎么合并pdf转word后段落合并软领PDF阅读转换器
热门文章更多文章



 提示