


 有用科技小编2026/10/09
 浏览9759
 阅读12分钟
PDF 怎么转换成 Word 文档步骤不复杂,真正费时间的是转完之后页眉页码混进正文。怎么处理看它们在原文件里属于哪一层:能选中的是文本层,在 Word 里删行或用查找替换批量清;选不中的是图片层,回 PDF 端裁掉上下边缘再转。
多数情况是转换时页眉页脚被当成正文段落一起还原了,原文件本身没坏,不必重新排版,也不用重做文档。以下方法在 Windows 10/11 实测可用。
适用系统:Windows 10/11;最后更新:2026-10-09。
转出来的 Word 为什么每页都顶着书名和页码
打开转出的文档,第一行是原 PDF 的书名,最后一行是「第 1 页 共 12 页」。点上去会出现编辑光标,说明它们是普通正文段落,而 Word 的页眉页脚区域是空的。
原 PDF 导出时,页眉页脚常常是普通文本框,或者一整张页边框图片。转换器按版面坐标还原内容,分不清哪一行是页眉,就一起排进了正文,页数一多看着就乱。

先判断页眉页码属于哪一层,再决定删文字还是裁图片,比挨个办法试过去省时间。
方法1 先分清页眉页码是文本层还是图片层
能选中的是文本层,转后直接在 Word 里删;怎么拖都选不中的是图片层,只能裁掉或删图。这一步花十几秒,能省下后面半小时的乱删。
操作步骤
- 在 PDF 阅读器里按住鼠标从左往右划过页眉文字,能高亮选中的就是文本层
- 怎么拖都选不中、只能整块框选的,多半是图片层,转成 Word 后会变成一张浮动图片
- 用 Ctrl+F 搜一个页脚页码数字,搜得到同样说明它在文本层
- 扫描件基本整页都是图片,页眉页脚也属于图片层,先记下判断结果再决定后面走删文字还是裁图片路线
文本层的页码在 Word 里就是普通段落,方法2、方法3 都能清掉。整页选不中文字的,直接跳到方法4,从 PDF 端动手更快。

方法2 转成 Word 后逐行删掉残留页码
页数不多时这招最快,定位到残留那一行整行选中删掉。页眉里的固定书名要先双击进页眉区再删,两者操作不一样。
操作步骤
- Word 里把光标放到页码那一行行首,按 Shift+End 选中整行再 Delete
- 固定书名类的页眉:双击页眉区域进入编辑,选中文字直接删,再双击正文退出
- 页脚页码同样双击页脚区删,注意「链接到前一节」会让删除同时影响后面所有节
- 删完按 Ctrl+End 跳到文末复查有没有漏行,再往上翻两页核对
- 残留的浮动图片:点中按 Delete,找不到就在开始→选择→选择窗格里定位后删除
光标有没有真的进到页眉里,看正文有没有变灰就知道。变灰说明进去了,这时候按 Delete 删的是页眉内容,动不到正文一个字。
文档超过二十页就别一行一行删了,改用方法3 的通配符替换,几秒清完整篇。
方法3 用查找替换批量清掉纯数字孤行
页数一多,逐行删就慢了。用查找替换一次清完整篇的独立页码,是 pdf转word格式 转换后最省事的清理方式,前提是页码自己占一行。
操作步骤
- 按 Ctrl+H 打开查找和替换,点左下角「更多」展开高级选项
- 勾选「使用通配符」
- 查找框填 ^13([0-9]{1,3})^13,替换框填 ^13,点「全部替换」,独立成行的 1-3 位纯数字页码会被清掉
- 不用通配符时,可以先在查找框填 ^p^p 把连续空段落合并,再处理残留空行
- 替换前先另存一份备份,替换后逐段核对正文有没有被误删
- 页码和页眉文字连在同一行时通配符清不掉,直接转到方法4处理
^13 代表一个段落标记,[0-9]{1,3} 表示 1 到 3 位数字,两头各夹一个段落标记,正好框住独占一行的页码。正文里夹在句子中间的数字不会被误伤。
'/%3E%3Crect%20x='28'%20y='94'%20width='122'%20height='78'%20rx='12'%20fill='%23ffffff'%20stroke='%232b86f0'%20stroke-width='2'/%3E%3Ccircle%20cx='48'%20cy='94'%20r='15'%20fill='%232b86f0'/%3E%3Ctext%20x='48.0'%20y='99'%20font-family='Segoe%20UI,Microsoft%20YaHei,PingFang%20SC,sans-serif'%20font-size='14'%20fill='%23ffffff'%20text-anchor='middle'%20font-weight='700'%3E1%3C/text%3E%3Ctext%20x='89.25'%20y='129.0'%20font-family='Segoe%20UI,Microsoft%20YaHei,PingFang%20SC,sans-serif'%20font-size='14'%20fill='%231f2d3d'%20text-anchor='middle'%20font-weight='600'%3ECtrl+H%20打开替%3C/text%3E%3Ctext%20x='89.25'%20y='149.0'%20font-family='Segoe%20UI,Microsoft%20YaHei,PingFang%20SC,sans-serif'%20font-size='14'%20fill='%231f2d3d'%20text-anchor='middle'%20font-weight='600'%3E换%3C/text%3E%3Cpath%20d='M154%20124%20l9%209%20l-9%209'%20fill='none'%20stroke='%232b86f0'%20stroke-width='3'%20stroke-linecap='round'%20stroke-linejoin='round'/%3E%3Crect%20x='168'%20y='94'%20width='122'%20height='78'%20rx='12'%20fill='%23ffffff'%20stroke='%232b86f0'%20stroke-width='2'/%3E%3Ccircle%20cx='188'%20cy='94'%20r='15'%20fill='%232b86f0'/%3E%3Ctext%20x='188.5'%20y='99'%20font-family='Segoe%20UI,Microsoft%20YaHei,PingFang%20SC,sans-serif'%20font-size='14'%20fill='%23ffffff'%20text-anchor='middle'%20font-weight='700'%3E2%3C/text%3E%3Ctext%20x='229.75'%20y='138.0'%20font-family='Segoe%20UI,Microsoft%20YaHei,PingFang%20SC,sans-serif'%20font-size='15'%20fill='%231f2d3d'%20text-anchor='middle'%20font-weight='600'%3E勾选使用通配符%3C/text%3E%3Cpath%20d='M295%20124%20l9%209%20l-9%209'%20fill='none'%20stroke='%232b86f0'%20stroke-width='3'%20stroke-linecap='round'%20stroke-linejoin='round'/%3E%3Crect%20x='309'%20y='94'%20width='122'%20height='78'%20rx='12'%20fill='%23ffffff'%20stroke='%232b86f0'%20stroke-width='2'/%3E%3Ccircle%20cx='329'%20cy='94'%20r='15'%20fill='%232b86f0'/%3E%3Ctext%20x='329.0'%20y='99'%20font-family='Segoe%20UI,Microsoft%20YaHei,PingFang%20SC,sans-serif'%20font-size='14'%20fill='%23ffffff'%20text-anchor='middle'%20font-weight='700'%3E3%3C/text%3E%3Ctext%20x='370.25'%20y='129.0'%20font-family='Segoe%20UI,Microsoft%20YaHei,PingFang%20SC,sans-serif'%20font-size='14'%20fill='%231f2d3d'%20text-anchor='middle'%20font-weight='600'%3E^13([0-9]{1,3}%3C/text%3E%3Ctext%20x='370.25'%20y='149.0'%20font-family='Segoe%20UI,Microsoft%20YaHei,PingFang%20SC,sans-serif'%20font-size='14'%20fill='%231f2d3d'%20text-anchor='middle'%20font-weight='600'%3E)^13%3C/text%3E%3Cpath%20d='M436%20124%20l9%209%20l-9%209'%20fill='none'%20stroke='%232b86f0'%20stroke-width='3'%20stroke-linecap='round'%20stroke-linejoin='round'/%3E%3Crect%20x='450'%20y='94'%20width='122'%20height='78'%20rx='12'%20fill='%232b86f0'%20stroke='%232b86f0'%20stroke-width='2'/%3E%3Ccircle%20cx='470'%20cy='94'%20r='15'%20fill='%23155fc4'/%3E%3Ctext%20x='469.5'%20y='99'%20font-family='Segoe%20UI,Microsoft%20YaHei,PingFang%20SC,sans-serif'%20font-size='14'%20fill='%23ffffff'%20text-anchor='middle'%20font-weight='700'%3E4%3C/text%3E%3Ctext%20x='510.75'%20y='138.0'%20font-family='Segoe%20UI,Microsoft%20YaHei,PingFang%20SC,sans-serif'%20font-size='15'%20fill='%23ffffff'%20text-anchor='middle'%20font-weight='600'%3E全部替换%3C/text%3E%3C/svg%3E)
替换属于改完不容易退回的操作,动手前把文件另存成「报告_原始.docx」,改坏了还能从头再来。
用「软领PDF阅读转换器」更省事
软领PDF阅读转换器的 PDF转Word 功能,能直接从 PDF 转出可编辑的 Word 文档。先在阅读器里把页面上下边缘裁掉一条,再让 PDF转Word 去转,页眉页码就不会被当成正文段落带进新文档,转后逐行清理的返工直接省掉。
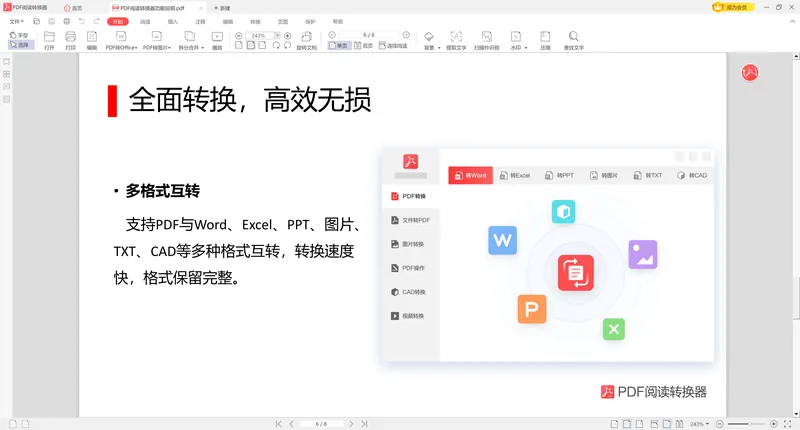
软领是知名国产软件品牌,20 年技术沉淀,服务千万用户。软件从软领官网 wyouhua.com 直接下载,安装过程没有捆绑勾选项。
转换前想先看看裁剪后的效果,可以在软件里过一遍页面预览再动手。遇到版式特别复杂的合同或表格,点界面上的客服按钮能联系到真人客服,后台有工程师远程协助。
方法4 回 PDF 端裁掉页眉页脚再重新转换
图片层页码,或者页码和页眉文字挤在同一行的,在 Word 里删不干净。从源头裁掉上下边缘最稳,一次解决整篇。
操作步骤
- 回到 PDF 阅读器,用编辑或裁剪功能把页面上下边缘各裁掉一小条
- 预览确认页眉页脚已经落在裁剪框外,另存为新 PDF
- 用带 PDF转Word 功能的转换器把这份新 PDF 转成 Word 文档
- 打开转出的文档翻到首页和末页,确认正文里不再带出书名和页码
- 扫描件要先做文字识别再裁剪,否则裁完剩下的内容仍是图片,照样删不动
PDF 阅读器里的裁剪只改页面的显示范围,不改文件里的原始内容,裁多了还能把框拉回来重来,放心试。
裁好之后另存成「报告_已裁.pdf」,别直接覆盖原件。原件留着,万一后面发现正文也被裁掉一行,还能重新裁一次。
方法5 转前走一遍检查清单,防止页码再混进正文
把判断文件类型、裁掉页眉页脚区域、检查转后残留固定成习惯,比转完再返工省事。经常处理 PDF 的话,这一遍花一分钟就够。
操作步骤
- 转前确认文件是文本型还是扫描型,看能不能直接选中一段文字
- 扫描型先跑一遍文字识别,文本型直接进入下一步
- 转换前把上下边缘各裁掉一小条页眉页脚区域
- 转完立刻按 Ctrl+End 跳到文末,看末尾有没有多出页码行或空页
- 再看「页眉/页脚」是不是被整体套了一版统一内容,确认干净后再开始改正文排版

检查顺序固定下来以后,同一批文件可以照着一遍过完。先裁、再转、转完看文末,这三步走顺了,页码基本不会再混进正文。
常见问题
PDF转Word后页码变成正文数字,怎么一次批量删掉?
按 Ctrl+H 打开查找和替换,点「更多」勾上「使用通配符」,查找框填 ^13([0-9]{1,3})^13,替换框填 ^13,点「全部替换」。独立成行的 1 到 3 位数字页码会一次清掉,替换前先另存一份副本。
PDF转Word后每页都有页眉书名,双击页眉区删不掉是什么原因?
这些书名落在正文里,不在页眉区,双击页眉区当然是空的。把光标放到那一行行首,按 Shift+End 选中整行再 Delete 就能删掉,逐页处理一遍即可。
用 ^13([0-9]{1,3})^13 替换页码没反应,通配符哪里没设置对?
多半是没勾「使用通配符」。另外把输入法切到英文半角,括号和花括号要用英文符号,全角的符号匹配不到任何内容,点全部替换会显示替换 0 处。
扫描版PDF转Word后页眉页脚变成图片,怎么处理?
先跑一遍文字识别,再回 PDF 端把上下边缘各裁掉一条,然后重新转一次。不裁的话识别结果里照样带页眉页码,而且是图片,在 Word 里选都选不中。
PDF转Word后文末多出半页空白,是页脚没清干净吗?
多半是页脚位置留下的空段落。把光标放到最后一页末尾,选中多余空行删掉;残留的浮动图片用「开始→选择→选择窗格」找到后删除。
推荐阅读
PDF怎么转换成Word文档,转完一行一个回车怎样合并回整段
PDF转Word格式乱了怎么调整,每页多出的分节符和重复页眉一起清
相关推荐
PDF导出高清图片体积太大,多半是DPI、格式和页码范围没设对
Word转PDF图片模糊,先分清是导出压缩还是转换DPI的问题
 pdf转word页眉页码怎么删pdf转word格式pdf怎么转换成word文档格式软领PDF阅读转换器



 提示